

内容
<!-- mcp-name: io.github.zhaoyue722/llm-usage-mcp -->
<p align="center">
<img src="https://raw.githubusercontent.com/zhaoyue722/llm-usage-mcp/main/docs/assets/watch-pom.png" alt="llm-usage-mcp" width="140">
</p>
<h1 align="center">LLM 使用监控</h1>
<p align="center"><em>你的 LLM 消费监控</em></p>
<p align="center">
<a href="https://github.com/zhaoyue722/llm-usage-mcp/actions/workflows/ci.yml"><img src="https://github.com/zhaoyue722/llm-usage-mcp/actions/workflows/ci.yml/badge.svg" alt="持续集成"></a>
<a href="https://github.com/zhaoyue722/llm-usage-mcp/blob/main/LICENSE"><img src="https://img.shields.io/badge/License-MIT-blue.svg" alt="许可证:MIT"></a>
<a href="https://www.python.org/downloads/"><img src="https://img.shields.io/badge/python-3.13%2B-blue.svg" alt="Python 3.13+"></a>
</p>
<p align="center">English | <a href="https://github.com/zhaoyue722/llm-usage-mcp/blob/main/README.zh.md">中文</a></p>
不要再把你的 LLM API 账单当作恐怖电影一样,每个月末才敢看。了解你的 LLM 调用实际成本 - 跨所有提供商,集中在一个地方,在你自己的机器上。询问你的编码代理(MCP)或输入命令(CLI)。
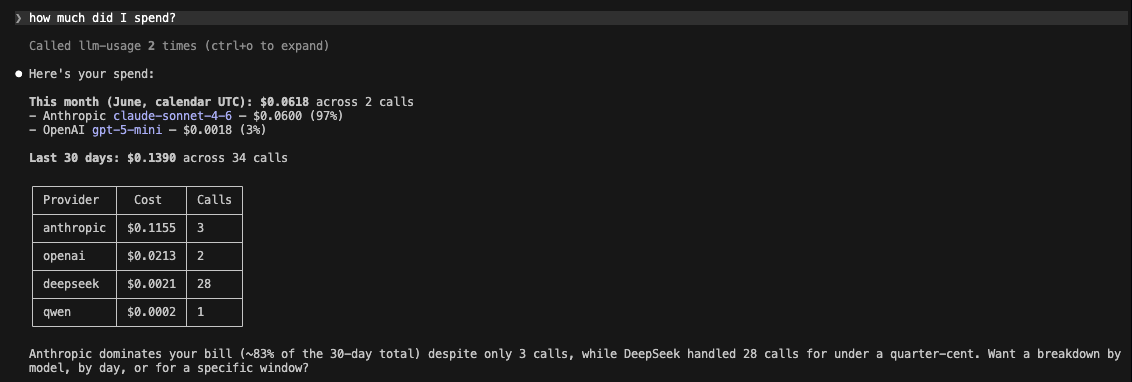
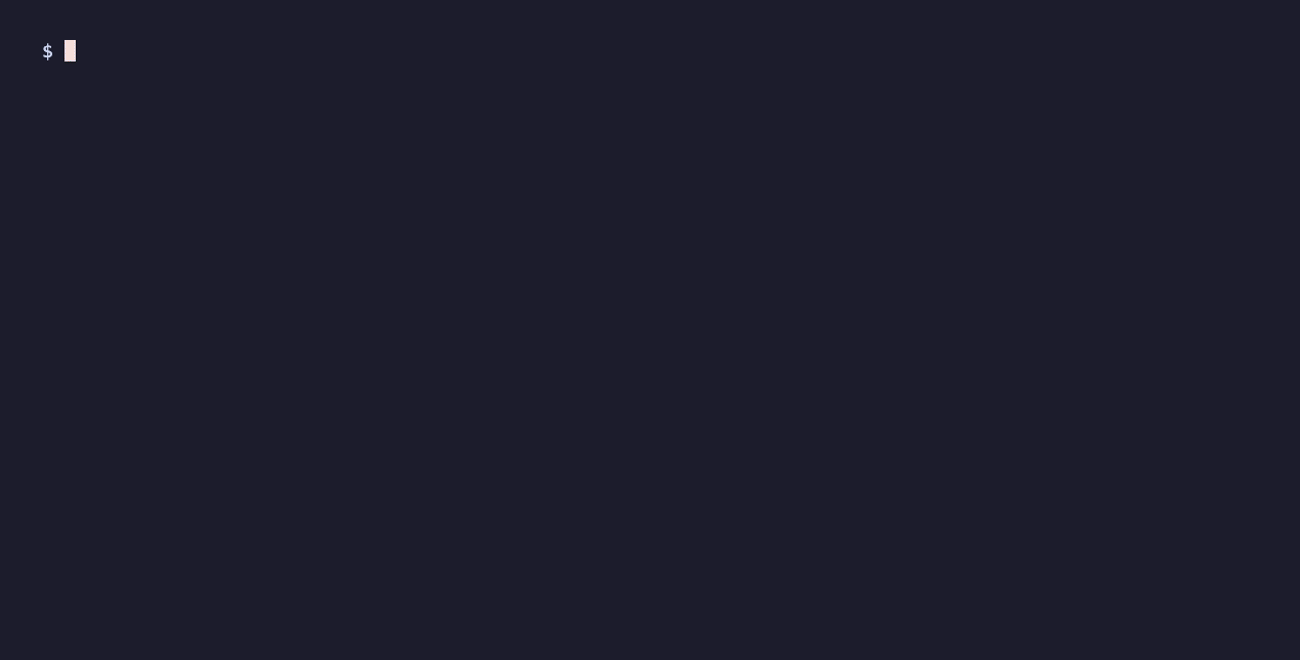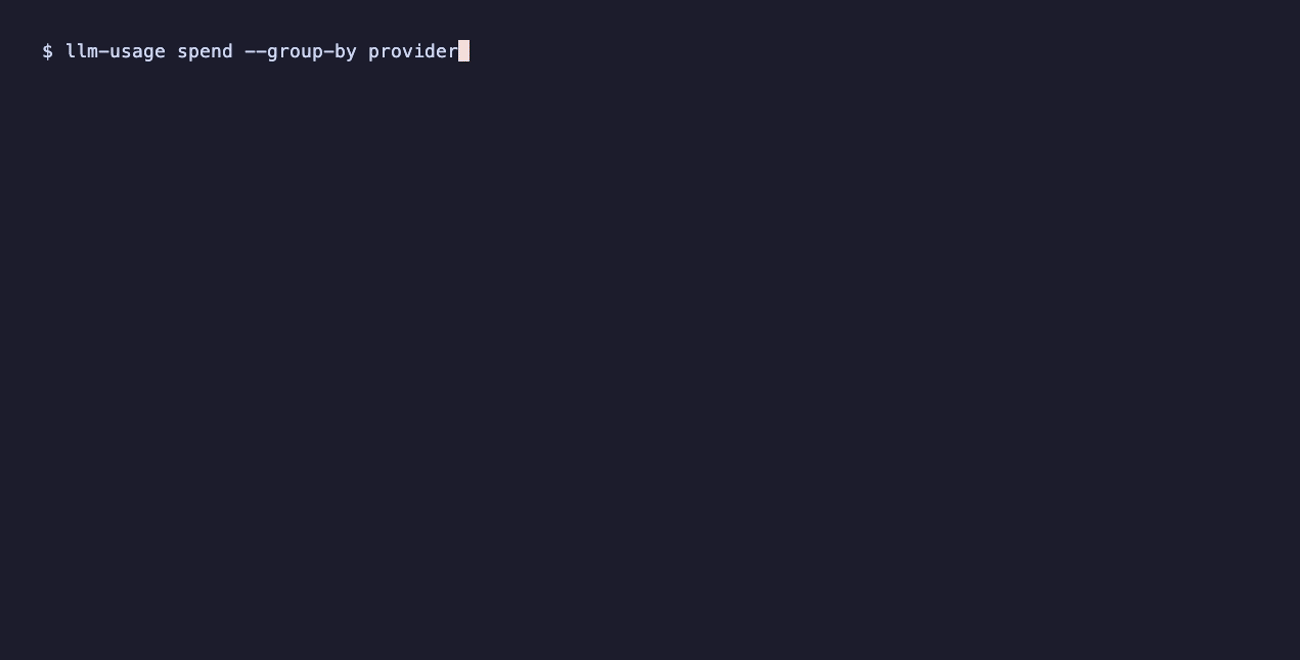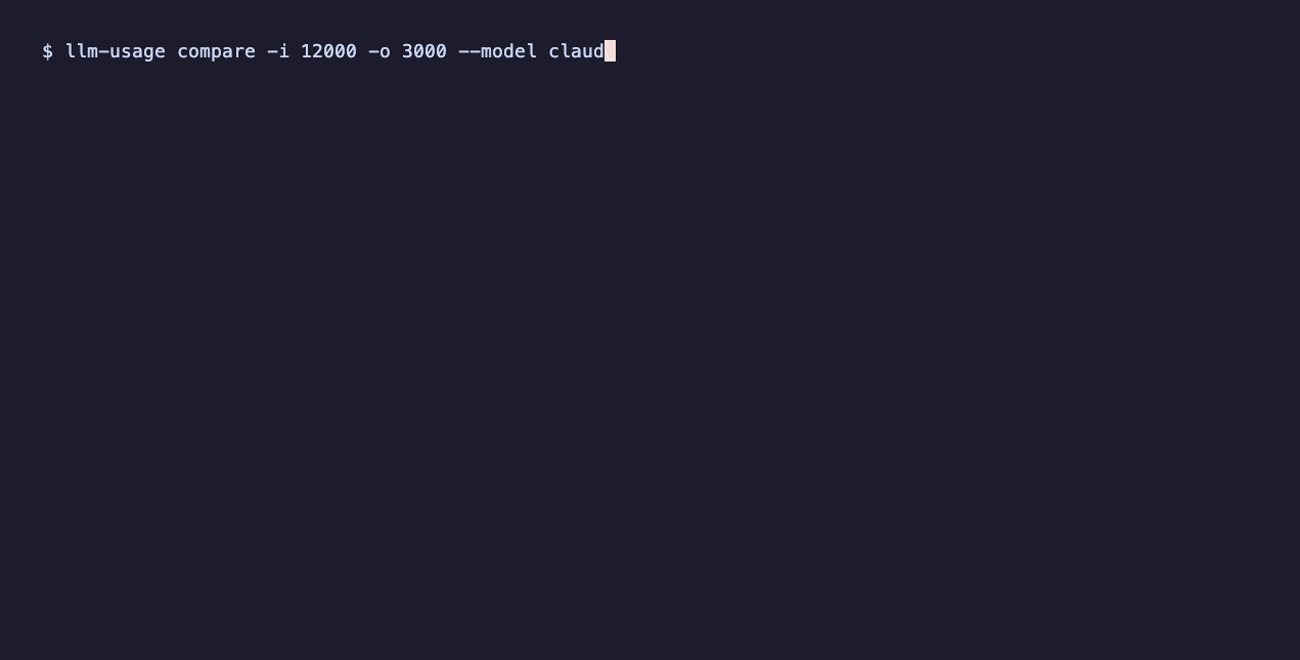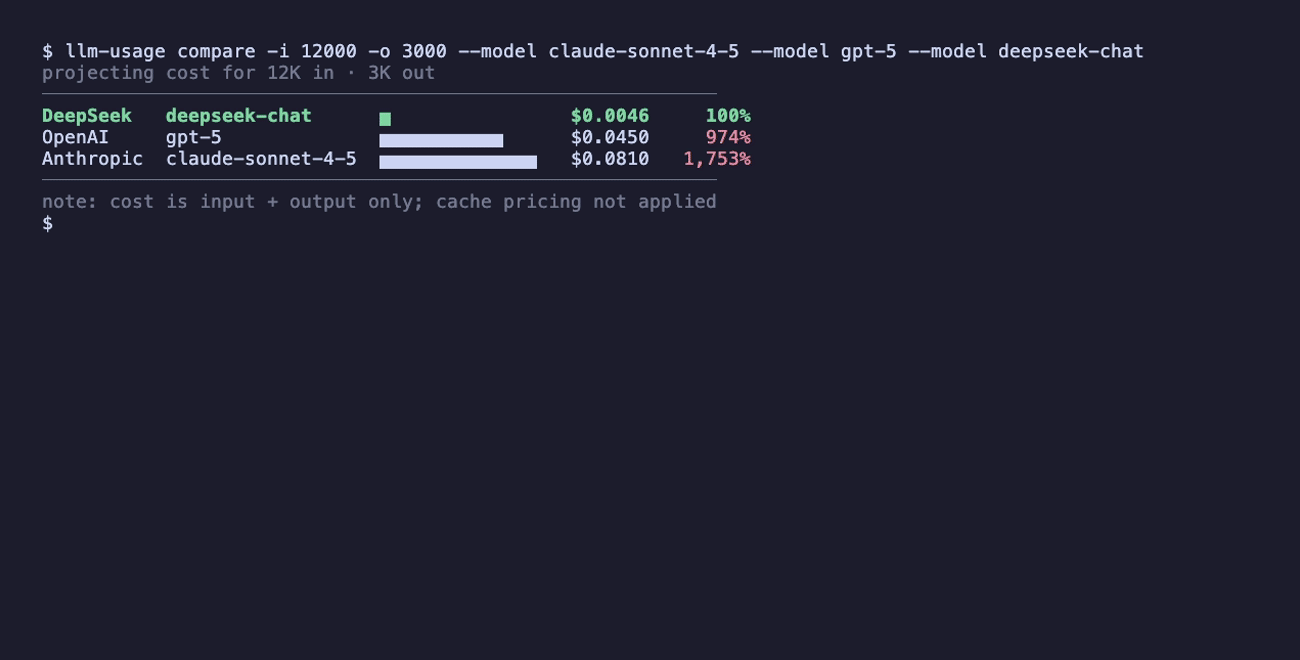
或者直接从终端 - 你的每周消费,按提供商分类,并与模型提交前进行跨提供商成本比较:
## 为什么你需要这个
你正在从少数提供商调用 LLMs - Claude、GPT,以及像 Qwen 和 DeepSeek 这样的中文模型。每个提供商都有自己的仪表盘、货币和缓存代币成本规则。因此,最简单的问题 - *我花了多少钱,花的在哪?* - 变成四个浏览器登录,查找人民币兑美元汇率,并试图理解“缓存上下文代币折扣”在午夜数学中的含义。大多数人只是交叉手指,希望月底账单不要太惊讶。
`llm-usage-mcp` 捕获你每次调用,存入本地存储,按提供商正确计算成本,并在发生时返回答案 **两种方式**:
- **询问你的编码代理。** 它是一个 MCP 服务器,因此 Claude Code、Cursor 或任何 MCP 客户端都可以以普通英语回答 *“我这周在 Claude 上花了多少钱?”* 或 *“哪个提供商对于 10k 输入 / 2k 输出调用最便宜?”*。
- **或输入命令。** 它也是一个 CLI - `llm-usage spend`、`llm-usage compare`、`llm-usage recommend` - 适用于你不想通过代理进行操作的情况。
并且它不会干扰你的工作:
- **本地优先。** 没有 SaaS,没有注册,没有遥测。只在 `~/.llm-usage/usage.db` 处有一个 SQLite 文件。隐私是一项功能,而不是设置。
- **多提供商,包括中文模型。** Anthropic、OpenAI、DeepSeek、Qwen - 所有四种提供商都支持流式和非流式。DeepSeek 和 Qwen 运行与 Anthropic 和 OpenAI 相同的捕获路径,而不是临时添加的。更多提供商(Gemini、Bedrock、Moonshot 等)正在 [路上](#supported-providers)。
## 快速开始
从 `git clone` 到你的第一个捕获调用,只需两分钟。本部分是关于 **捕获** - 记录调用。 [读取数据](#querying-your-spend) 接下来。
### 1. 安装
使用 [uv](https://docs.astral.sh/uv/) (或 `pipx`)从 PyPI 安装 - 这会将三个控制台脚本放入你的 `PATH` 中:
```bash
uv tool install llm-usage-mcp # 或:pipx install llm-usage-mcp
```
如果你更喜欢在此基础上进行开发?克隆并从源代码同步:
```bash
git clone https://github.com/zhaoyue722/llm-usage-mcp.git
cd llm-usage-mcp
uv sync
```
无论哪种方式,你都会得到三个控制台脚本:
- `llm-usage` - 多命令 CLI。参见下面的 [从命令行(CLI)](#from-the-command-line-cli)。
- `llm-usage-mcp` - 标准输入/输出 MCP 服务器。
- `llm-usage-proxy` - 向后兼容别名;与 `llm-usage proxy` 相同。
> 以下快速入门使用 `uv run …` (源代码工作流)。如果你从 PyPI 安装,脚本已经在你的 `PATH` 中 - 删除 `uv run` 前缀,并使用 `claude mcp add llm-usage -- llm-usage-mcp` 注册 MCP 服务器。
### 2. 设置至少一个 API 密钥
你只需要使用你实际使用的提供商(s)的密钥;代理启动与否,取决于路由请求是否返回 `503 configuration_error`,对于任何缺少密钥的提供商。
```bash
export ANTHROPIC_API_KEY=sk-ant-...
# 和/或:
export OPENAI_API_KEY=sk-...
export DEEPSEEK_API_KEY=sk-...
export DASHSCOPE_API_KEY=sk-... # Qwen
```
完整的环境变量参考: [`docs/configuration.md`](https://github.com/zhaoyue722/llm-usage-mcp/blob/main/docs/configuration.md) (或复制 [.env.example](https://github.com/zhaoyue722/llm-usage-mcp/blob/main/.env.example) 到 `.env` 并填写)。
### 3. 运行捕获代理
```bash
uv run llm-usage-proxy
```
它绑定到 **仅限本地回路** (`127.0.0.1:5525`) - 永远无法从网络访问。代理在服务器端保存你的 API 密钥;客户端永远不需要它们。
### 4. 将你的编码代理指向代理
代理为每个提供商暴露一个路由。设置客户端一侧的匹配 `*_BASE_URL` 环境变量:
| 提供商 | 客户端环境变量 | 值 |
|---|---|---|
| Anthropic | `ANTHROPIC_BASE_URL` | `http://127.0.0.1:5525` |
| OpenAI | `OPENAI_BASE_URL` | `http://127.0.0.1:5525/openai/v1` |
| DeepSeek | `DEEPSEEK_BASE_URL` (或任何 OpenAI-SDK 基本 URL 重写) | `http://127.0.0.1:5525/deepseek/v1` |
| Qwen | DashScope OpenAI 兼容基本 | `http://127.0.0.1:5525/qwen/v1` |
示例 - 启动 Claude Code 并将调用路由到代理:
```bash
ANTHROPIC_BASE_URL=http://127.0.0.1:5525 claude
```
### 5. 确认它正在捕获
通过你的代理(或指向代理的任何客户端)进行调用,然后检查它是否成功:
```bash
uv run llm-usage spend
```
每次调用都存储在 `~/.llm-usage/usage.db` 中,包含代币、成本、延迟和用于幂等性的 `request_id` - 并显示在该标题中。这就是整个循环:捕获在一边,答案在另一边。
## 查询你的消费
一旦调用被捕获,你可以通过两种方式读取它们。相同的数据,相同的数字 - 选择适合当前情况的即可。
### 询问你的编码代理(MCP)
在 Claude Code 中注册 MCP 服务器:
```bash
claude mcp add llm-usage -- uv --directory $(pwd) run llm-usage-mcp
```
然后直接询问,用普通英语,在该会话中:
> 我今天在 Anthropic 上花了多少钱?哪个提供商对于 10k 输入 / 2k 输出调用最便宜?
Claude 选择合适的工具并读取数字。七种工具通过标准输入/输出公开;完整的参数/返回形状在 [`docs/spec.md`](https://github.com/zhaoyue722/llm-usage-mcp/blob/main/docs/spec.md) 中。
| 工具 | 目的 |
|---|---|
| `query_spend` | 指定时间窗口内的总消费 + 按组汇总(按提供商/模型/项目/标签/天分组)。 |
| `usage_summary` | 今日/本月/年的消费总结 - 总消费、主要提供商 + 模型、最大调用。 |
| `compare_providers` | 给定假设的工作负载(输入/输出代币),按成本排名每个定价模型。 |
| `recommend_provider` | 选择最便宜的定价模型,以满足声明的预算。 |
| `get_pricing` | 检查供应商的定价快照。 |
| `list_providers` | 列出提供商 + 它们的模型 + OpenAI 兼容性标志。 |
| `record_usage` | 手动写入路径 - 在未使用捕获代理的情况下记录调用。 |
`query_spend` 和 `usage_summary` 默认 `include_failed=false`,因此部分流式传输的行不会污染总数;可以通过参数选择加入。
### 从命令行(CLI)
相同的疑问,作为 CLI - 一个 `llm-usage` 控制台下的八个子命令,当输入比询问代理更快时使用。
> 以下示例假设 `llm-usage` 在你的 `PATH` 中 - 或者 `source .venv/bin/activate` 或 `uv tool install .`。否则,在每个命令前添加 `uv run` 前缀(例如 `uv run llm-usage spend`)。
```text
$ llm-usage
本地首选的 LLM 消费捕获 + 查询,通过 MCP 暴露。
命令
proxy 在 127.0.0.1 上运行本地 LLM 捕获代理。
compare 投射假设工作负载在每个定价模型上的成本。
models 浏览本地定价目录。
recommend 推荐适用于工作负载 + 预算的最便宜定价模型。
spend 显示在日历期间记录的消费。
status 本地安装的快照:数据库、代理、提供商、定价。
providers 列出配置的提供商及其密钥状态、线格式、模型数量。
about 显示版本、作者、许可证和项目主页。
```
| 命令 | 它回答的问题 |
|---|---|
| [`compare`](#compare) | 给定工作负载,谁最便宜? |
| [`models`](#models) | 它们实际按百万代币收费多少? |
| [`recommend`](#recommend) | 我还剩 $0.04 - 哪个模型不会让我破产? |
| [`spend`](#spend) | 我刚刚花了多少钱? |
| [`status`](#status) | 一切真的正常吗? |
| [`providers`](#providers) | 本地配置了什么? |
| [`about`](#about) | 这是什么,以及在哪里报告错误? |
| `proxy` | 运行捕获代理(与 `llm-usage-proxy` 相同)。 |
跨每个命令一致的约定:
- `--json` 发出与匹配的 MCP 工具返回的相同 Pydantic 形状。直接输送到 `jq`。
- `--color {auto,always,never}` 遵循 `NO_COLOR` 和 TTY 检测。调色板是温暖、低对比度的深色主题 - 在 11 点钟时对眼睛很友好。
- 过滤标志( `--provider` 、 `--model` )对提供商不区分大小写,对模型区分大小写,并且在作为白名单的情况下可重复。
- `--version` / `-V` 打印版本并退出。 `--install-completion {bash|zsh|fish|powershell}` 安装 tab 补全脚本 - 一个 shell 重启后,每个标志都可以通过 `<Tab>` 补全。
#### `compare`
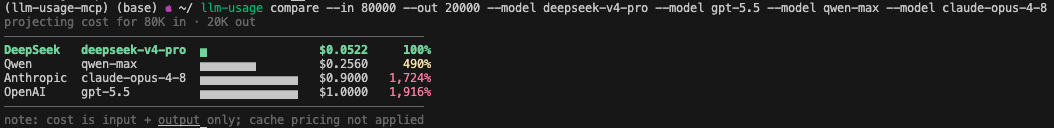
按预测成本对每个定价模型进行排名,适用于 `n` 输入 / `m` 输出调用。最便宜的优先,百分比对抗最便宜的。默认视图系列消除共享相同模型家族根和相同价格的行 - 因此 `gpt-5-mini` 和 `gpt-5-mini-2025-08-07` 折叠为一行,显示 `×2`。传递 `--all` 以查看每个目录行。
```bash
# 8k 输入 / 2k 输出调用今天的价格是多少?
$ llm-usage compare --in 8000 --out 2000
# 仅限 OpenAI 模型:
$ llm-usage compare --in 8000 --out 2000 --model gpt-5-mini --model gpt-5-nano
# 相同的预测,以 JSON 格式输出,用于脚本:
$ llm-usage compare --in 8000 --out 2000 --json | jq '.ranked[0]'
```
#### `models`
目录浏览器。与 `compare` 相似,但回答的是“这个模型收费多少?”而不是“我的工作负载成本多少?”。按提供商的字母顺序排序,默认为每百万代币的费率;使用 `--sort input` 或 `--sort output` 切换到任一轴上查找最便宜的。
```bash
# 完整的目录,已去重。
$ llm-usage models
# 仅限 OpenAI 的 nano 模型,包含缓存费率:
$ llm-usage models --provider openai --match nano --cache
# 输入费率最低优先 - 快速“当前底线是多少?”:
$ llm-usage models --sort input
```
#### `recommend`
选择一个。按 `--provider` 、 `--model` 和 `--budget` 过滤,然后返回最便宜的匹配项以及两个亚军。推理字符串解释了假设的内容和选择的内容,因此您可以进行健全性检查,而不是盲目信任。
```bash
# 最便宜的定价模型,绝对便宜。
$ llm-usage recommend
# Anthropic 中任何适合 1k/1k 调用且低于一美分的项目:
$ llm-usage recommend --provider anthropic --budget 0.01
# 在这三个特定候选者中,哪一个胜出?
$ llm-usage recommend --model gpt-5-mini --model claude-sonnet-4-6 --model qwen-max
```
v1 仅按成本排名。 `--task` 是可选的,出现在推理文本中;它不会驱动选择(该工具不是 LLM,无法解释自由文本)。
#### `spend`
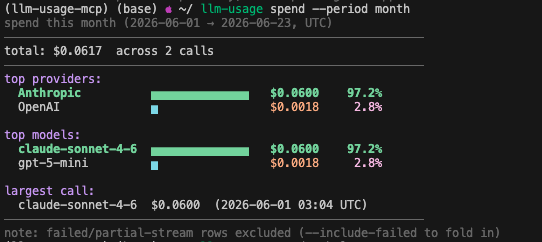
读取 SQLite。默认视图是 `usage_summary` 标题 - 总美元、主要提供商、主要模型、最大调用。传递 `--group-by` 切换到汇总模式。
```bash
# 本周的标题。
$ llm-usage spend
# 本月按模型分组的 JSON,用于仪表盘:
$ llm-usage spend --period month --group-by model --json | jq
# 特定项目标签的每日消费:
$ llm-usage spend --group-by day --project my-side-thing
```
时间边界是日历 UTC: `today` = 自 00:00 UTC 开始, `week` = 自星期一开始, `month` = 自 1 日开始, `year` = 自 1 月 1 日开始。 默认情况下,失败/部分流式传输的行被排除;使用 `--include-failed` 选择加入。
#### `status`
一屏,四部分:数据库、捕获代理、提供商、定价。“一切真的正常吗?” 命令。只读 - 在你安装后但未曾启动代理或 MCP 服务器时运行它,会打印 `database not initialized` 而不是静默创建文件。
```bash
$ llm-usage status
# 跳过网络探测(离线、CI、慢速链接):
$ llm-usage status --no-net
# 适用于健康检查脚本的机器可读格式:
$ llm-usage status --json
```
#### `providers`
按提供商的配置视图。比 `status` 提供商块更宽:添加线格式标志( `openai-compat: yes/no` )和可选的 `--models` 扩展,列出每个提供商的每个定价模型。
```bash
$ llm-usage providers
$ llm-usage providers --models # 展开每个提供商及其模型列表
```
#### `about`
前门面板:版本、作者、许可证和项目主页。与 `--version` 的人性化伴侣 - 字段从安装的包元数据中读取,因此它们与 PyPI 显示的内容相匹配。
```bash
$ llm-usage about
# 机器可读,用于脚本或问题模板:
$ llm-usage about --json
```
## 支持的提供商
| 提供商 | 认证 | 非流式 | 流式 | 缓存定价 |
|---|---|---|---|---|
| Anthropic | `x-api-key` | 是 | 是 | `cache_creation` + `cache_read` |
| OpenAI | `Bearer` | 是 | 是 | 嵌套 `prompt_tokens_details.cached_tokens` |
| DeepSeek | `Bearer` | 是 | 是 | `prompt_cache_hit_tokens` / `_miss_tokens` |
| Qwen (DashScope) | `Bearer` | 是 | 是 | 通常在 OpenAI 兼容端点上省略 |
**更多正在筹备中。** Google Gemini、AWS Bedrock、Moonshot (Kimi)、Zhipu GLM、MiniMax 等等都在 [`docs/post_v1_providers.md`](https://github.com/zhaoyue722/llm-usage-mcp/blob/main/docs/post_v1_providers.md) 中有范围。
**价格来源。** 定价是 LiteLLM 定价 JSON 的精简快照,[LiteLLM 定价 JSON](https://github.com/BerriAI/litellm/blob/main/litellm/model_prices_and_context_window_backup.json),每周由 GitHub Action 刷新( [`refresh-pricing.yml`](.github/workflows/refresh-pricing.yml) )。LiteLLM 尚未支持的模型通过 [`pricing_overrides.json`](src/llm_usage/core/pricing_data/pricing_overrides.json) 本地填充。
## 配置
所有内容都是环境变量(或存储库根目录的 `.env` 文件)。默认设置是合理的 - 启动代理不需要任何设置。完整的参考资料: [`docs/configuration.md`](https://github.com/zhaoyue722/llm-usage-mcp/blob/main/docs/configuration.md)。您可能最关心的三个:
| 变量 | 默认值 | 目的 |
|---|---|---|
| `LLM_USAGE_DB_URL` | `sqlite:///$HOME/.llm-usage/usage.db` | 本地数据库的位置。 |
| `LLM_USAGE_PROXY_PORT` | `5525` | 捕获代理端口(仅限本地回路)。 |
| `LLM_USAGE_<PROVIDER>_BASE_URL` | 每个提供商的官方端点 | 将提供商指向反向代理/网关 - 在网络受限的区域很有用。 |
## 许可证
[MIT](https://github.com/zhaoyue722/llm-usage-mcp/blob/main/LICENSE).
MCP 配置
以下是此 MCP Server 的配置信息,可直接复制到 Cursor 或其他 MCP 客户端中使用。
mcp.json
连接信息
猜你喜欢
暂无推荐服务器