

内容
<div align="center">
# WeChat Download API
### 微信公众号文章获取 · RSS 订阅 · 多格式导出
**完全开源 | 免费部署 | RSS 订阅 | 文章抓取 | 多格式导出 | 反风控**
[](https://github.com/tmwgsicp/wechat-download-api/stargazers)
[](LICENSE)
[](https://hub.docker.com/r/tmwgsicp/wechat-download-api)
[](https://www.python.org/)
[](https://fastapi.tiangolo.com/)
> **100% 开源,100% 免费。** 代码完全公开,私有化部署无任何限制,不搞"开源"之名行收费之实。
</div>
---
## 功能特性
- **RSS 订阅** — 订阅任意公众号,自动定时拉取新文章(**包含完整文章内容和图片**),生成标准 RSS 2.0 源,接入 FreshRSS / Feedly 等阅读器即可使用;支持**批量添加**(粘多个公众号名称一次性订阅)
- **MCP · AI 客户端接入** — 内置 MCP 服务,Claude / Codex / Cline / Cursor 等 AI 客户端可**直接搜索、订阅、读文章**(6 个工具,静态 Token 鉴权,单用户自托管无需 OAuth)
- **文章内容获取** — 通过 URL 获取文章完整内容(标题、作者、正文 HTML / 纯文本、图片列表)
- **多格式导出** — 单篇 markdown 增量同步(带 YAML frontmatter,导入 Obsidian / Logseq);整号文章一键打包成 **Markdown / HTML / Word / PDF / EPUB / Excel / JSON** 7 种格式(Word/PDF/EPUB 图片内嵌离线可看),纯读本地库、不触发抓取
- **反风控体系** — Chrome TLS 指纹模拟 + SOCKS5 代理池轮转 + 三层自动限频,有效对抗微信封控
- **文章列表 & 搜索** — 获取任意公众号历史文章列表,支持分页和关键词搜索
- **公众号搜索** — 按名称搜索公众号,获取 FakeID
- **公众号主体信息** — 获取公众号认证主体、认证状态、原创文章数等详细信息
- **扫码登录** — 微信公众平台扫码登录,凭证自动保存,4 天有效期
- **图片代理** — 代理微信 CDN 图片,解决防盗链问题
- **Webhook 通知** — 登录过期提醒(提前24h/6h预警+已过期通知)、触发验证等事件自动推送(支持企业微信机器人)
- **API 文档** — 自动生成 Swagger UI / ReDoc,在线调试所有接口
<div align="center">
<img src="assets/dashboard.jpg" width="800" alt="管理面板">
<p><em>管理面板 — 登录状态、接口文档、在线测试一站式管理</em></p>
<br>
<img src="assets/rss.jpg" width="800" alt="RSS 订阅管理">
<p><em>RSS 订阅管理 — 搜索公众号一键订阅,复制地址接入 RSS 阅读器</em></p>
</div>
---
## 📦 整号导出,随身带走
订阅只是第一步。**把整个公众号的存量文章一键打包成你想要的格式**——喂给 AI、导入笔记、离线存档、换设备迁移,全都行。
- ❌ 一篇一篇复制粘贴,图片还丢失
- ❌ 想喂给 AI,却拿不到干净的 Markdown
- ❌ 换阅读器 / 换设备,历史内容带不走
- ✅ **一个公众号一键打包**,7 种格式任选,**纯读本地库、不触发任何微信抓取**(零风控风险)
| 格式 | 后缀 | 适合场景 | 图片 | 单次上限 |
|------|------|----------|------|----------|
| 📝 Markdown 合集 | `.zip` | 归档 / 喂 AI / 导入 Obsidian、Logseq | 引用式 | 3000 |
| 🌐 HTML 合集 | `.html` | 单文件、带目录、暗色适配,浏览器直接看 | 引用式 | 3000 |
| 📊 Excel | `.xlsx` | 文章清单表(标题 / 作者 / 时间 / 链接) | — | 3000 |
| 🔧 JSON | `.json` | 二次开发 / 数据分析 | — | 3000 |
| 📄 Word | `.docx` | 可编辑文档,图去重压缩 | **内嵌** | 500 |
| 📕 PDF | `.pdf` | 固定排版、内置中文字体免装 | **内嵌** | 200 |
| 📱 EPUB | `.epub` | 手机 / 电子书阅读器读合集 | **内嵌** | 500 |
> **文本/表格类**(Markdown / HTML / Excel / JSON)图片引用式、秒出、零抓图带宽;**离线自包含类**(Word / PDF / EPUB)会把微信图现抓内嵌进文件、断网也能看图。全部只导已抓到正文的文章,支持按时间范围(全部 / 最近 N 天 / 时间窗 / 增量)筛选。
在 **RSS 管理页**(`/rss.html`)每个订阅右侧点「**下载文章**」即可可视化选格式与时间范围;也可直接调接口 `GET /api/export/account/{fakeid}.{格式}`,详见下方 [整号文章导出(多格式)](#整号文章导出多格式)。
---
## Docker 部署 🐳
**最快速的部署方式**,无需配置 Python 环境,一键启动:
```bash
# 方式一:使用 docker-compose(推荐)
git clone https://github.com/tmwgsicp/wechat-download-api.git
cd wechat-download-api
cp env.example .env
# 编辑 .env 设置 SITE_URL 为实际访问地址
docker-compose up -d
# 方式二:直接运行
docker run -d \
-p 5000:5000 \
-v $(pwd)/data:/app/data \
-v $(pwd)/.env:/app/.env \
--name wechat-api \
tmwgsicp/wechat-download-api:latest
```
服务启动后访问 `http://localhost:5000/login.html` 扫码登录即可使用。
**支持多架构**:`linux/amd64` / `linux/arm64`(Apple Silicon、树莓派、ARM 服务器)
---
## SaaS 托管版 — 已上线 🚀
**不想折腾部署?30 秒注册即可使用** 👉 **[wechatrss.waytomaster.com](https://wechatrss.waytomaster.com)**
搜索公众号名称,拿到 RSS 链接,丢进你的阅读器——Feedly、Inoreader、NetNewsWire 全部兼容。
---
## 使用前提
> 本工具需要通过微信公众平台后台的登录凭证来调用接口,因此使用前需要:
1. **拥有一个微信公众号**(订阅号、服务号均可)
2. 部署并启动服务后,访问登录页面用**公众号管理员微信**扫码登录
3. 登录成功后凭证自动保存到 `.env` 文件,有效期约 **4 天**,过期后需重新扫码
登录后即可通过 API 获取**任意公众号**的公开文章(不限于自己的公众号)。
> **本地电脑可以直接使用!** 不需要公网服务器——在本地启动服务后通过 `localhost` 访问即可完成扫码登录和全部功能。只有当你需要从其他设备(如手机 RSS 阅读器)远程访问时,才需要公网服务器或内网穿透。
---
## 快速开始
### 方式一:Docker 部署(推荐)
```bash
# 1. 克隆项目
git clone https://github.com/tmwgsicp/wechat-download-api.git
cd wechat-download-api
# 2. 配置环境变量
cp env.example .env
# 编辑 .env,设置 SITE_URL 为实际访问地址(如 http://your-domain.com)
# 3. 启动服务
docker-compose up -d
# 4. 查看日志
docker-compose logs -f
```
### 方式二:一键脚本部署
**第一步:克隆项目**
```bash
git clone https://github.com/tmwgsicp/wechat-download-api.git
cd wechat-download-api
```
**第二步:一键启动**
```bash
bash start.sh # Linux/macOS
# 或
start.bat # Windows
```
脚本会自动完成环境检查、虚拟环境创建、依赖安装和服务启动。
**第三步:扫码登录**
访问 `http://localhost:5000/login.html`,用**公众号管理员微信**扫码登录。
---
## API 使用
### 访问地址
| 地址 | 说明 |
|------|------|
| http://localhost:5000 | 管理面板 |
| http://localhost:5000/login.html | 扫码登录 |
| http://localhost:5000/api/docs | Swagger API 文档 |
| http://localhost:5000/api/health | 健康检查 |
---
## 服务器部署
### Linux 生产环境(systemd)
`start.sh` 脚本在 Linux 上以 `sudo` 运行时,会自动注册 systemd 服务并启用开机自启:
```bash
sudo bash start.sh
```
之后可通过以下命令管理服务:
```bash
# 查看运行状态
bash status.sh
# 停止服务
bash stop.sh
# 手动操作
sudo systemctl restart wechat-download-api
sudo systemctl status wechat-download-api
```
### 配置反向代理(可选)
如需通过域名或 HTTPS 访问,配置 Nginx 反向代理到 `localhost:5000`:
```nginx
server {
listen 80;
server_name your-domain.com;
location / {
proxy_pass http://127.0.0.1:5000;
proxy_set_header Host $host;
proxy_set_header X-Real-IP $remote_addr;
proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
}
}
```
### 环境变量
复制 `env.example` 为 `.env` 并按需修改:
```bash
cp env.example .env
```
主要配置项参见 `env.example` 中的注释说明。
---
## MCP — AI 客户端接入
内置 **MCP(Model Context Protocol)服务**,让 Claude、Codex、Cline、Cursor 等 AI 客户端**直接搜索公众号、订阅、读文章**,不用切网页、不用手动调接口——对 AI 说"帮我订阅 XX 公众号、把最新几篇总结一下"即可。
**6 个工具:**
| 工具 | 作用 |
|------|------|
| `search_accounts` | 按名称搜索公众号,拿 fakeid |
| `subscribe_account` | 订阅公众号(传 fakeid) |
| `unsubscribe_account` | 取消订阅 |
| `list_subscriptions` | 列出已订阅的公众号 |
| `get_recent_articles` | 拉最新文章(支持时间游标增量、按公众号过滤) |
| `read_article` | 读某篇文章的完整正文 |
**启用(`.env`):** 单用户自托管,鉴权走**静态 Bearer Token**,无需 OAuth。`ENABLE_MCP` 和 `MCP_TOKEN` **两者都要设置**,缺一则 MCP 不启用。
```bash
ENABLE_MCP=1
MCP_TOKEN=设一个足够长的随机串 # 客户端凭它鉴权(必填,留空则不启用)
# MCP_RESOURCE_URL=https://你的域名/mcp # 部署到公网域名时设(DNS-rebinding 白名单)
```
服务挂载在 `/mcp`(streamable-http)。
**客户端配置:**
```bash
# Claude Code
claude mcp add --transport http wechatrss https://你的域名/mcp \
--header "Authorization: Bearer <MCP_TOKEN>"
```
```jsonc
// Cursor / Cline 等(JSON 配置)
{
"mcpServers": {
"wechatrss": {
"url": "https://你的域名/mcp",
"headers": { "Authorization": "Bearer <MCP_TOKEN>" }
}
}
}
```
> 本地自测:`http://localhost:5000/mcp`。启用后未带正确 Token 会返回 401。
---
## API 接口
> 以下 HTTP 接口**无需鉴权**:调用方不用传任何 Token 或 `Authorization` 头。微信登录态由服务端扫码登录后内部持有并自动使用(前提是管理页面已扫码登录)。`MCP_TOKEN` / `Authorization: Bearer` 仅用于上面的 MCP 客户端接入,与这些 HTTP 接口无关。
>
> 文章解析与公众号搜索/文章列表接口(`/api/article`、`/api/public/searchbiz`、`/api/public/accountinfo`、`/api/public/articles`、`/api/public/articles/search`)统一返回 `{ "success": bool, "data": {...}, "error": null }`,**业务数据都在 `data` 字段下**;业务失败(如登录态失效)返回 HTTP 200 且 `success: false`,请以 `success` 字段判断成败。(增量同步接口 `/api/feed/articles.json` 与 `/api/health` 直接返回数据对象、不带此包装;RSS 接口返回 XML;`/api/feed/article/{id}.md` 返回 markdown 文本。)
### 获取文章内容
`POST /api/article` — 解析微信公众号文章,返回标题、正文、图片等结构化数据
| 参数 | 类型 | 必填 | 说明 |
|------|------|------|------|
| `url` | string | 是 | 微信文章链接(`https://mp.weixin.qq.com/s/...`) |
请求示例:
```bash
curl -X POST http://localhost:5000/api/article \
-H "Content-Type: application/json" \
-d '{"url": "https://mp.weixin.qq.com/s/xxxxx"}'
```
返回字段(均在 `data` 下):`title` 标题、`content` HTML 正文、`plain_content` 纯文本正文、`images` 图片 URL 列表、`author` 作者、`publish_time` 发布时间戳(秒)、`publish_time_str` 可读发布时间(如 `2026-02-24 09:00:00`)
### 搜索公众号
`GET /api/public/searchbiz` — 按关键词搜索微信公众号,获取 FakeID
| 参数 | 类型 | 必填 | 说明 |
|------|------|------|------|
| `query` | string | 是 | 搜索关键词(公众号名称) |
请求示例:
```bash
curl "http://localhost:5000/api/public/searchbiz?query=公众号名称"
```
返回示例:
```json
{
"success": true,
"data": {
"list": [
{
"fakeid": "MzI5NjM4MjExMg==",
"nickname": "示例公众号",
"alias": "example_wx",
"round_head_img": "http://你的部署地址/api/image?url=...",
"service_type": 1
}
],
"total": 1
},
"error": null
}
```
返回字段(公众号列表在 `data.list` 下):
- `fakeid` — 公众号唯一 ID(后续获取文章、订阅时使用)
- `nickname` — 公众号名称
- `alias` — 微信号
- `round_head_img` — 头像地址(已转为服务器图片代理链接)
- `service_type` — 类型(`0`=订阅号 / `1`=服务号 / `2`=企业号)
- `data.total` — 匹配数量(已过滤黑名单后的条数)
### 获取公众号主体信息
`GET /api/public/accountinfo` — 获取公众号的认证主体、认证状态、原创文章数等信息
| 参数 | 类型 | 必填 | 说明 |
|------|------|------|------|
| `fakeid` | string | 是 | 公众号的 FakeID(从搜索接口获取) |
请求示例:
```bash
curl "http://localhost:5000/api/public/accountinfo?fakeid=YOUR_FAKEID"
```
返回示例:
```json
{
"success": true,
"data": {
"identity_name": "腾讯科技(深圳)有限公司",
"is_verify": 2,
"original_article_count": 15234
}
}
```
返回字段:
- `identity_name` — 认证主体名称(公司/机构名称)
- `is_verify` — 认证状态(`0`=未认证, `1`=微信认证, `2`=新媒体认证)
- `original_article_count` — 原创文章总数
### 获取文章列表
`GET /api/public/articles` — 获取指定公众号的文章列表,支持分页
| 参数 | 类型 | 必填 | 说明 |
|------|------|------|------|
| `fakeid` | string | 是 | 目标公众号的 FakeID(从搜索接口获取) |
| `begin` | int | 否 | 偏移量,默认 `0` |
| `count` | int | 否 | 获取数量,默认 `10`,最大 `100` |
| `keyword` | string | 否 | 在该公众号内搜索关键词 |
请求示例:
```bash
# 获取前 50 篇
curl "http://localhost:5000/api/public/articles?fakeid=YOUR_FAKEID&begin=0&count=50"
# 获取第 51-100 篇
curl "http://localhost:5000/api/public/articles?fakeid=YOUR_FAKEID&begin=50&count=50"
```
返回示例:
```json
{
"success": true,
"data": {
"articles": [
{
"aid": "2650000000_1",
"title": "示例文章标题",
"link": "https://mp.weixin.qq.com/s/AbCdEfGhIj",
"update_time": 1700000000,
"create_time": 1699999000,
"digest": "文章摘要",
"cover": "http://mmbiz.qpic.cn/cover/0",
"author": "作者名"
}
],
"total": 42,
"begin": 0,
"count": 1,
"keyword": null
},
"error": null
}
```
返回字段(文章列表在 `data.articles` 下):
- `aid` — 文章 ID
- `title` — 标题
- `link` — 文章链接
- `update_time` / `create_time` — 更新 / 创建时间戳
- `digest` — 摘要
- `cover` — 封面图地址
- `author` — 作者
- `data.total` — 该公众号文章总数(微信侧);`data.count` — 本次返回条数;`data.begin` — 本次偏移量;`data.keyword` — 本次搜索关键词(未传为 `null`)
### 搜索公众号文章
`GET /api/public/articles/search` — 在指定公众号内按关键词搜索文章
| 参数 | 类型 | 必填 | 说明 |
|------|------|------|------|
| `fakeid` | string | 是 | 目标公众号的 FakeID |
| `query` | string | 是 | 搜索关键词 |
| `begin` | int | 否 | 偏移量,默认 `0` |
| `count` | int | 否 | 获取数量,默认 `10`,最大 `100` |
请求示例:
```bash
curl "http://localhost:5000/api/public/articles/search?fakeid=YOUR_FAKEID&query=关键词"
```
返回结构与「获取文章列表」一致(文章列表在 `data.articles` 下,`data.keyword` 为本次搜索词)。
### RSS 订阅
`GET /api/rss/{fakeid}` — 获取指定公众号的 RSS 2.0 订阅源
| 参数 | 类型 | 必填 | 说明 |
|------|------|------|------|
| `fakeid` | string(路径) | 是 | 公众号 FakeID |
| `limit` | int(查询) | 否 | 返回文章数量上限,默认 `20` |
使用方式:
```bash
# 1. 搜索公众号获取 fakeid
curl "http://localhost:5000/api/public/searchbiz?query=人民日报"
# 返回 fakeid: MzA1MjM1ODk2MA==
# 2. 添加订阅
curl -X POST http://localhost:5000/api/rss/subscribe \
-H "Content-Type: application/json" \
-d '{"fakeid": "MzA1MjM1ODk2MA==", "nickname": "人民日报"}'
# 3. 手动触发一次轮询(立即拉取文章)
curl -X POST http://localhost:5000/api/rss/poll
# 4. 获取 RSS 源(把这个地址添加到 RSS 阅读器)
curl "http://localhost:5000/api/rss/MzA1MjM1ODk2MA=="
```
也可以通过管理面板的 **RSS 订阅** 页面可视化管理,搜索公众号一键订阅并复制 RSS 地址。
> **关于 RSS 内容**: RSS 源包含**完整文章内容**(图文混排),您可以直接在 RSS 阅读器中阅读全文。
>
> 系统使用 **SOCKS5 代理池 + Chrome TLS 指纹模拟**技术获取文章内容,有效规避微信风控。
>
> 扫码登录后,系统会**自动**将微信凭证用于内容获取,无需手动配置。如需禁用完整内容获取(仅保留标题和摘要),可在 `.env` 中设置 `RSS_FETCH_FULL_CONTENT=false`。
#### RSS 订阅管理接口
| 方法 | 路径 | 说明 |
|------|------|------|
| `POST` | `/api/rss/subscribe` | 添加 RSS 订阅 |
| `DELETE` | `/api/rss/subscribe/{fakeid}` | 取消 RSS 订阅 |
| `GET` | `/api/rss/subscriptions` | 获取订阅列表 |
| `POST` | `/api/rss/poll` | 手动触发轮询 |
| `GET` | `/api/rss/status` | 轮询器状态 |
| `GET` | `/api/rss/all` | **聚合源** — 所有订阅合成一个 RSS,阅读器里加一条就够 |
| `GET` | `/api/rss/category/{category_id}` | **分类源** — 某个分类下所有订阅合成一个 RSS |
| `GET` | `/api/rss/{fakeid}/history` | 单个公众号的历史文章 RSS |
| `GET` | `/api/rss/export` | 导出订阅列表(备份 / 迁移) |
> **分类管理**:可把订阅分组(`GET/POST /api/categories`、`PUT/DELETE /api/categories/{id}`、`POST /api/subscriptions/{fakeid}/category`),再用上面的**分类源**按主题订阅,或用**聚合源**一条读全部。
### Markdown 导出 / 文章同步
把已抓取的文章拉成 markdown(带 YAML frontmatter),可直接导入 Obsidian / Logseq 等工具。
`GET /api/feed/articles.json` — 列出本地已抓取的文章元数据(含文章 `id`),按时间游标增量同步
| 参数 | 类型 | 必填 | 说明 |
|------|------|------|------|
| `since` | int(查询) | 否 | Unix 时间戳,返回 `publish_time > since` 的文章;首次传 `0` |
| `fakeid` | string(查询) | 否 | 只看某个公众号 |
| `limit` | int(查询) | 否 | 单次返回条数(1-200),默认 `50` |
响应含 `next_since`(本批最后一篇的发布时间),作为下次 `since` 循环调用,拉到 `articles` 为空即同步完成;之后用保存的 `next_since` 做每日增量。
`GET /api/feed/article/{id}.md` — 按 `id` 获取单篇文章的 markdown 正文(带 title / author / nickname / fakeid / publish_time / date(可读时间)/ source_url 等 frontmatter)
```bash
# 1. 拉文章列表拿 id(循环 since 直到返回空)
curl "http://localhost:5000/api/feed/articles.json?since=0&limit=200"
# 2. 按 id 下载某篇 markdown(浏览器 / 下载工具会自动存成「标题.md」)
curl -OJ "http://localhost:5000/api/feed/article/1.md"
```
状态码:`200` 正文 / `404` 不存在 / `422` 内容尚未抓取完成(稍后重试)。
### 整号文章导出(多格式)
把某个公众号**已抓取入库**的文章一次性打包下载,支持 7 种格式。**纯读本地库、不触发任何微信抓取**;在 RSS 管理页(`/rss.html`)每个订阅右侧点「下载文章」即可选格式与时间范围,也可直接调接口。
`GET /api/export/account/{fakeid}.{格式}`
| 格式 | 后缀 | 说明 | 图片 |
|------|------|------|------|
| Markdown 合集 | `.zip` | 每篇一个 `.md` + `INDEX.md`,适合归档 / 喂 AI | 引用式(指向 `/api/image` 代理) |
| HTML 合集 | `.html` | 单文件,带目录、暗色适配 | 引用式 |
| Excel | `.xlsx` | 文章清单表(标题 / 作者 / 时间 / 链接) | — |
| JSON | `.json` | 文章清单数据 | — |
| Word | `.docx` | 可编辑,图去重压缩 | **内嵌**(离线可看) |
| PDF | `.pdf` | 内置中文字体,排版固定 | **内嵌** |
| EPUB | `.epub` | 每篇一章 + 目录,手机 / 阅读器读合集 | **内嵌** |
| 参数 | 类型 | 必填 | 说明 |
|------|------|------|------|
| `since` | int(查询) | 否 | 只导 `publish_time >= since` 的文章(时间窗起点 / 增量),秒级时间戳 |
| `before` | int(查询) | 否 | 只导 `publish_time <= before` 的文章(时间窗终点) |
| `limit` | int(查询) | 否 | 最多导出篇数(最近优先)。md/html/xlsx/json 上限 3000,Word/EPUB 500,PDF 200 |
```bash
# 整号导出为 Markdown 合集 zip(浏览器 / -OJ 会按「公众号名_导出_N篇.zip」自动命名)
curl -OJ "http://localhost:5000/api/export/account/MzA1MjM1ODk2MA==.zip"
# 只导最近 30 天、导成 EPUB
SINCE=$(($(date +%s) - 30*86400))
curl -OJ "http://localhost:5000/api/export/account/MzA1MjM1ODk2MA==.epub?since=$SINCE"
```
> Markdown / HTML / Excel / JSON 用图片引用式,秒出、零抓图带宽(在线打开时显示图);Word / PDF / EPUB 会现抓微信图内嵌进文件、离线自带图,篇数多时稍慢。全部只导已抓到正文的文章。
### 其他接口
| 方法 | 路径 | 说明 |
|------|------|------|
| `GET` | `/api/image?url=IMG_URL` | 图片代理(仅限微信 CDN 域名) |
| `GET` | `/api/health` | 健康检查 |
| `GET` | `/api/stats` | 限频统计 |
| `POST` | `/api/login/session/{id}` | 初始化登录会话 |
| `GET` | `/api/login/getqrcode` | 获取登录二维码 |
| `GET` | `/api/login/scan` | 检查扫码状态 |
| `POST` | `/api/login/bizlogin` | 完成登录 |
| `GET` | `/api/login/info` | 获取登录信息 |
| `GET` | `/api/admin/status` | 查询登录状态 |
| `POST` | `/api/admin/logout` | 退出登录 |
完整的接口文档请访问 http://localhost:5000/api/docs
---
## 配置说明
复制 `env.example` 为 `.env`,登录后凭证会自动保存:
```bash
cp env.example .env
```
| 配置项 | 说明 | 默认值 |
|--------|------|--------|
| `WECHAT_TOKEN` | 微信 Token(登录后自动填充) | - |
| `WECHAT_COOKIE` | 微信 Cookie(登录后自动填充) | - |
| `WECHAT_FAKEID` | 公众号 FakeID(登录后自动填充) | - |
| `WECHAT_EXPIRE_TIME` | 凭证过期时间(登录后自动填充) | - |
| `WEBHOOK_URL` | Webhook 通知地址(支持企业微信机器人) | 空 |
| `WEBHOOK_NOTIFICATION_INTERVAL` | 同一事件通知最小间隔(秒) | 300 |
| `RATE_LIMIT_GLOBAL` | 全局每分钟请求上限 | 10 |
| `RATE_LIMIT_PER_IP` | 单 IP 每分钟请求上限 | 5 |
| `RATE_LIMIT_ARTICLE_INTERVAL` | 文章请求最小间隔(秒) | 3 |
| `RSS_POLL_INTERVAL` | RSS 轮询间隔(秒) | 3600 |
| `ARTICLES_PER_POLL` | 每次轮询每个公众号拉取的文章批次数 | 10 |
| `RSS_FETCH_FULL_CONTENT` | RSS 是否获取完整内容(true/false) | true |
| `PROXY_URLS` | **SOCKS5 代理池地址(强烈建议配置,避免账号风控)** | 空 |
| `SITE_URL` | **网站访问地址(用于RSS图片代理,必须配置)** | http://localhost:5000 |
| `PORT` | 服务端口 | 5000 |
| `HOST` | 监听地址 | 0.0.0.0 |
| `DEBUG` | 调试模式(开启热重载) | false |
> **⚠️ 重要**: `SITE_URL` 必须配置为实际访问地址(IP或域名),否则RSS图片无法正常显示。例如:
> - 本地开发: `http://localhost:5000`
> - 局域网部署: `http://192.168.1.100:5000`
> - 公网域名: `https://你的域名.com`
### SOCKS5 代理池配置(⚠️ 强烈建议)
**重要提示**:
- ⚠️ **启用完整内容获取时,强烈建议配置代理池,避免账号被微信风控**
- ⚠️ **不配置代理直连微信可能导致:频繁验证、账号限制、IP封禁**
- ✅ **配置2-3个代理IP可有效分散请求,降低风控风险**
**用途**:获取文章完整内容时分散请求 IP,配合 Chrome TLS 指纹模拟,有效规避微信风控。
> 本项目使用 `curl_cffi` 模拟 Chrome TLS 指纹,请求特征与真实浏览器一致,配合代理池效果更佳。
**方案:多台 VPS 自建 SOCKS5 代理**
准备 2-3 台低价 VPS(各大云厂商轻量应用服务器即可,¥20-30/月/台),每台运行一个 SOCKS5 代理服务。推荐 [gost](https://github.com/go-gost/gost)(Go 语言实现,单二进制文件,无依赖)。
**第一步:在每台 VPS 上安装 gost**
```bash
# 下载最新版(以 Linux amd64 为例,其他架构请去 GitHub Releases 页面选择)
# 国外服务器直接下载
wget https://github.com/go-gost/gost/releases/download/v3.2.6/gost_3.2.6_linux_amd64.tar.gz
# 国内服务器使用加速镜像(任选一个可用的)
wget https://gh-proxy.com/https://github.com/go-gost/gost/releases/download/v3.2.6/gost_3.2.6_linux_amd64.tar.gz
# 或
wget https://ghproxy.cc/https://github.com/go-gost/gost/releases/download/v3.2.6/gost_3.2.6_linux_amd64.tar.gz
# 解压并移动到系统路径
tar -xzf gost_3.2.6_linux_amd64.tar.gz
mv gost /usr/local/bin/
chmod +x /usr/local/bin/gost
# 验证安装
gost -V
```
**第二步:启动 SOCKS5 代理服务**
```bash
# 带用户名密码认证(推荐,替换 myuser / mypass 和端口)
gost -L socks5://myuser:mypass@:1080
# 不带认证(仅内网或已配置防火墙时使用)
gost -L socks5://:1080
```
**第三步:配置为 systemd 服务(开机自启)**
```bash
cat > /etc/systemd/system/gost.service << 'EOF'
[Unit]
Description=GOST Proxy
After=network.target
[Service]
Type=simple
ExecStart=/usr/local/bin/gost -L socks5://myuser:mypass@:1080
Restart=always
RestartSec=5
[Install]
WantedBy=multi-user.target
EOF
systemctl daemon-reload
systemctl enable gost
systemctl start gost
```
**第四步:开放防火墙端口**
```bash
# 仅允许你的主服务器 IP 连接(替换为实际 IP)
ufw allow from YOUR_MAIN_SERVER_IP to any port 1080
# 或者如果用的是云厂商安全组,在控制台添加入站规则:
# 端口 1080 / TCP / 来源 IP 限制为你的主服务器
```
**第五步:在主服务器 `.env` 中配置代理池**
```bash
PROXY_URLS=socks5://myuser:mypass@vps1-ip:1080,socks5://myuser:mypass@vps2-ip:1080,socks5://myuser:mypass@vps3-ip:1080
```
配置后重启服务,每次文章请求会轮流使用不同的代理 IP。可以通过 `GET /api/health` 确认代理池状态。留空则直连(默认行为)。
---
## 项目结构
```
├── app.py # FastAPI 主应用
├── requirements.txt # Python 依赖
├── env.example # 环境变量示例
├── data/ # 数据目录(运行时自动创建)
│ └── rss.db # RSS 订阅 SQLite 数据库
├── routes/ # API 路由
│ ├── article.py # 文章内容获取
│ ├── articles.py # 文章列表
│ ├── account.py # 公众号主体信息
│ ├── rss.py # RSS 订阅管理与输出
│ ├── search.py # 公众号搜索
│ ├── feed.py # 本地文章增量同步(articles.json / markdown 导出)
│ ├── login.py # 扫码登录
│ ├── admin.py # 管理接口
│ ├── image.py # 图片代理
│ ├── health.py # 健康检查
│ └── stats.py # 统计信息
├── mcp_server/ # MCP 服务(AI 客户端接入)
│ ├── server.py # MCP 服务端(静态 Bearer Token 鉴权)
│ ├── tools.py # MCP 工具(搜索/订阅/读文章等)
│ └── store_adapter.py # 公众号搜索/订阅数据适配
├── utils/ # 工具模块
│ ├── auth_manager.py # 认证管理
│ ├── helpers.py # HTML 解析
│ ├── http_client.py # HTTP 客户端(curl_cffi + 代理池)
│ ├── proxy_pool.py # 代理池轮转
│ ├── rate_limiter.py # 限频器
│ ├── rss_store.py # RSS 数据存储(SQLite)
│ ├── rss_poller.py # RSS 后台轮询器
│ ├── login_reminder.py # 登录过期提醒(主动检测)
│ ├── content_processor.py # 内容处理与图片代理
│ ├── image_proxy.py # 图片URL代理工具
│ ├── article_fetcher.py # 批量并发获取文章
│ └── webhook.py # Webhook 通知
└── static/ # 前端页面(含 RSS 管理)
```
---
## 内容类型与获取策略
本项目支持多种微信公众号内容类型,包括标准富文本、纯图片文章、图文消息、短内容、音频文章等。
详细说明请查看:**[CONTENT_TYPES.md](CONTENT_TYPES.md)**
**文档内容**:
- 所有支持的内容类型及 `item_show_type` 值
- 不可用状态识别(删除、违规、隐私、验证页面等)
- 反爬策略与代理配置
- 关键函数说明
- 开发贡献指南
---
## 常见问题
<details>
<summary><b>提示"服务器未登录"</b></summary>
访问 http://localhost:5000/login.html 扫码登录,凭证会自动保存到 `.env`。
</details>
<details>
<summary><b>触发微信风控 / 需要验证</b></summary>
1. 在浏览器中打开提示的文章 URL 完成验证
2. 等待 30 分钟后重试
3. 降低请求频率(系统已内置自动限频)
</details>
<details>
<summary><b>如何获取公众号的 FakeID</b></summary>
调用搜索接口:`GET /api/public/searchbiz?query=公众号名称`,从返回结果的 `fakeid` 字段获取。
</details>
<details>
<summary><b>Token 多久过期?如何提前知道?</b></summary>
Cookie 登录有效期约 4 天,系统会:
1. 前端显示到期时间(`/api/admin/status` 接口返回 `expireTime` 和 `isExpired` 字段)
2. **后台每 6 小时主动检测**,提前 24h / 6h 通过 Webhook 预警
3. 过期后立即通过 Webhook 通知
配置 `WEBHOOK_URL`(支持企业微信群机器人)可收到实时提醒,避免因凭证过期导致 RSS 轮询失败或搜索功能不可用。
</details>
<details>
<summary><b>可以同时登录多个公众号吗</b></summary>
当前版本不支持多账号。建议部署多个实例,每个登录不同公众号。
</details>
---
## 技术栈
| 层级 | 技术 |
|------|------|
| **Web 框架** | FastAPI |
| **ASGI 服务器** | Uvicorn |
| **HTTP 客户端** | curl_cffi(Chrome TLS 指纹)/ HTTPX(降级) |
| **反风控** | TLS 指纹模拟 + SOCKS5/HTTP 代理池轮转 |
| **RSS 存储** | SQLite(零配置,数据本地化) |
| **配置管理** | python-dotenv |
| **运行环境** | Python 3.8+ |
---
## 开源协议
本项目采用 **AGPL 3.0** 协议开源,**所有功能代码完整公开,私有化部署完全免费**。
| 使用场景 | 是否允许 |
|---------|---------|
| 个人学习和研究 | 允许,免费使用 |
| 企业内部使用 | 允许,免费使用 |
| 私有化部署 | 允许,免费使用 |
| 修改后对外提供网络服务 | 需开源修改后的代码 |
详见 [LICENSE](LICENSE) 文件。
### 免责声明
- 本软件按"原样"提供,不提供任何形式的担保
- 本项目仅供学习和研究目的,请遵守微信公众平台相关服务条款
- 使用者对自己的操作承担全部责任
- 因使用本软件导致的任何损失,开发者不承担责任
---
## 参与贡献
由于个人精力有限,目前**暂不接受 PR**,但非常欢迎:
- **提交 Issue** — 报告 Bug、提出功能建议
- **Fork 项目** — 自由修改和定制
- **Star 支持** — 给项目点 Star,让更多人看到
---
## 联系方式
<table>
<tr>
<td align="center">
<img src="assets/qrcode/wechat.jpg" width="200"><br>
<b>个人微信</b><br>
<em>技术交流 · 商务合作</em>
</td>
<td align="center">
<img src="assets/qrcode/sponsor.jpg" width="200"><br>
<b>赞赏支持</b><br>
<em>开源不易,感谢支持</em>
</td>
</tr>
</table>
- **GitHub Issues**: [提交问题](https://github.com/tmwgsicp/wechat-download-api/issues)
- **邮箱**: creator@waytomaster.com
- **SaaS 托管版**: [wechatrss.waytomaster.com](https://wechatrss.waytomaster.com)
---
## 致谢
- [FastAPI](https://fastapi.tiangolo.com/) — 高性能 Python Web 框架
- [curl_cffi](https://github.com/lexiforest/curl_cffi) — 支持浏览器 TLS 指纹模拟的 HTTP 客户端
- [HTTPX](https://www.python-httpx.org/) — 现代化 HTTP 客户端
- [gost](https://github.com/go-gost/gost) — 轻量级代理工具
---
<div align="center">
**如果觉得项目有用,请给个 Star 支持一下!**
[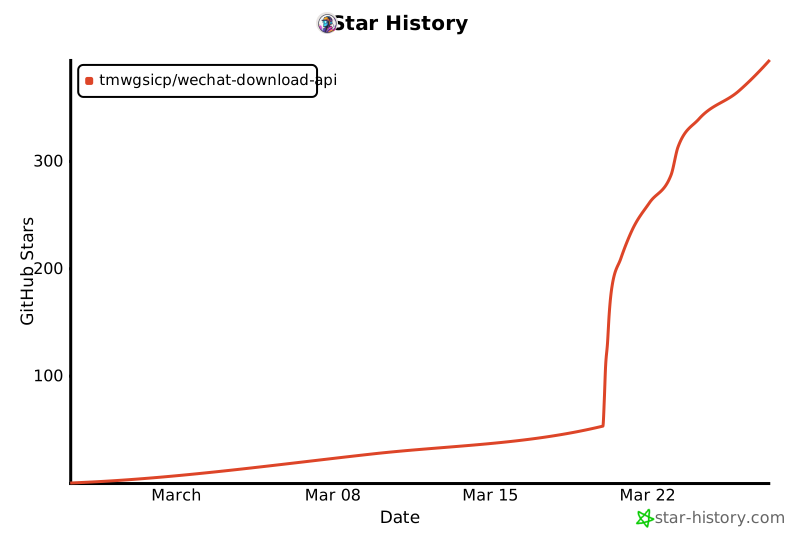](https://star-history.com/#tmwgsicp/wechat-download-api&Date)
Made with ❤️ by [tmwgsicp](https://github.com/tmwgsicp)
</div>
MCP 配置
以下是此 MCP Server 的配置信息,可直接复制到 Cursor 或其他 MCP 客户端中使用。
mcp.json
连接信息
猜你喜欢
暂无推荐服务器