内容
<!-- mcp-name: io.github.ZahiriNatZuke/local-delegate -->
# 本地委托
**将机械文本转换任务委托给本地LLM,以节省Claude订阅额度。**
一个MCP(stdio)服务器,作为任何与OpenAI兼容的端点的通用客户端 —
调用交换,Ollama,LM Studio,vLLM。
[](https://pypi.org/project/local-delegate-mcp/)
[](https://github.com/ZahiriNatZuke/local-delegate/actions/workflows/ci.yml)
[](./LICENSE)
## 演示
<!-- 绝对URL到raw.githubusercontent.com,以便在PyPI上也正确渲染图像 -->
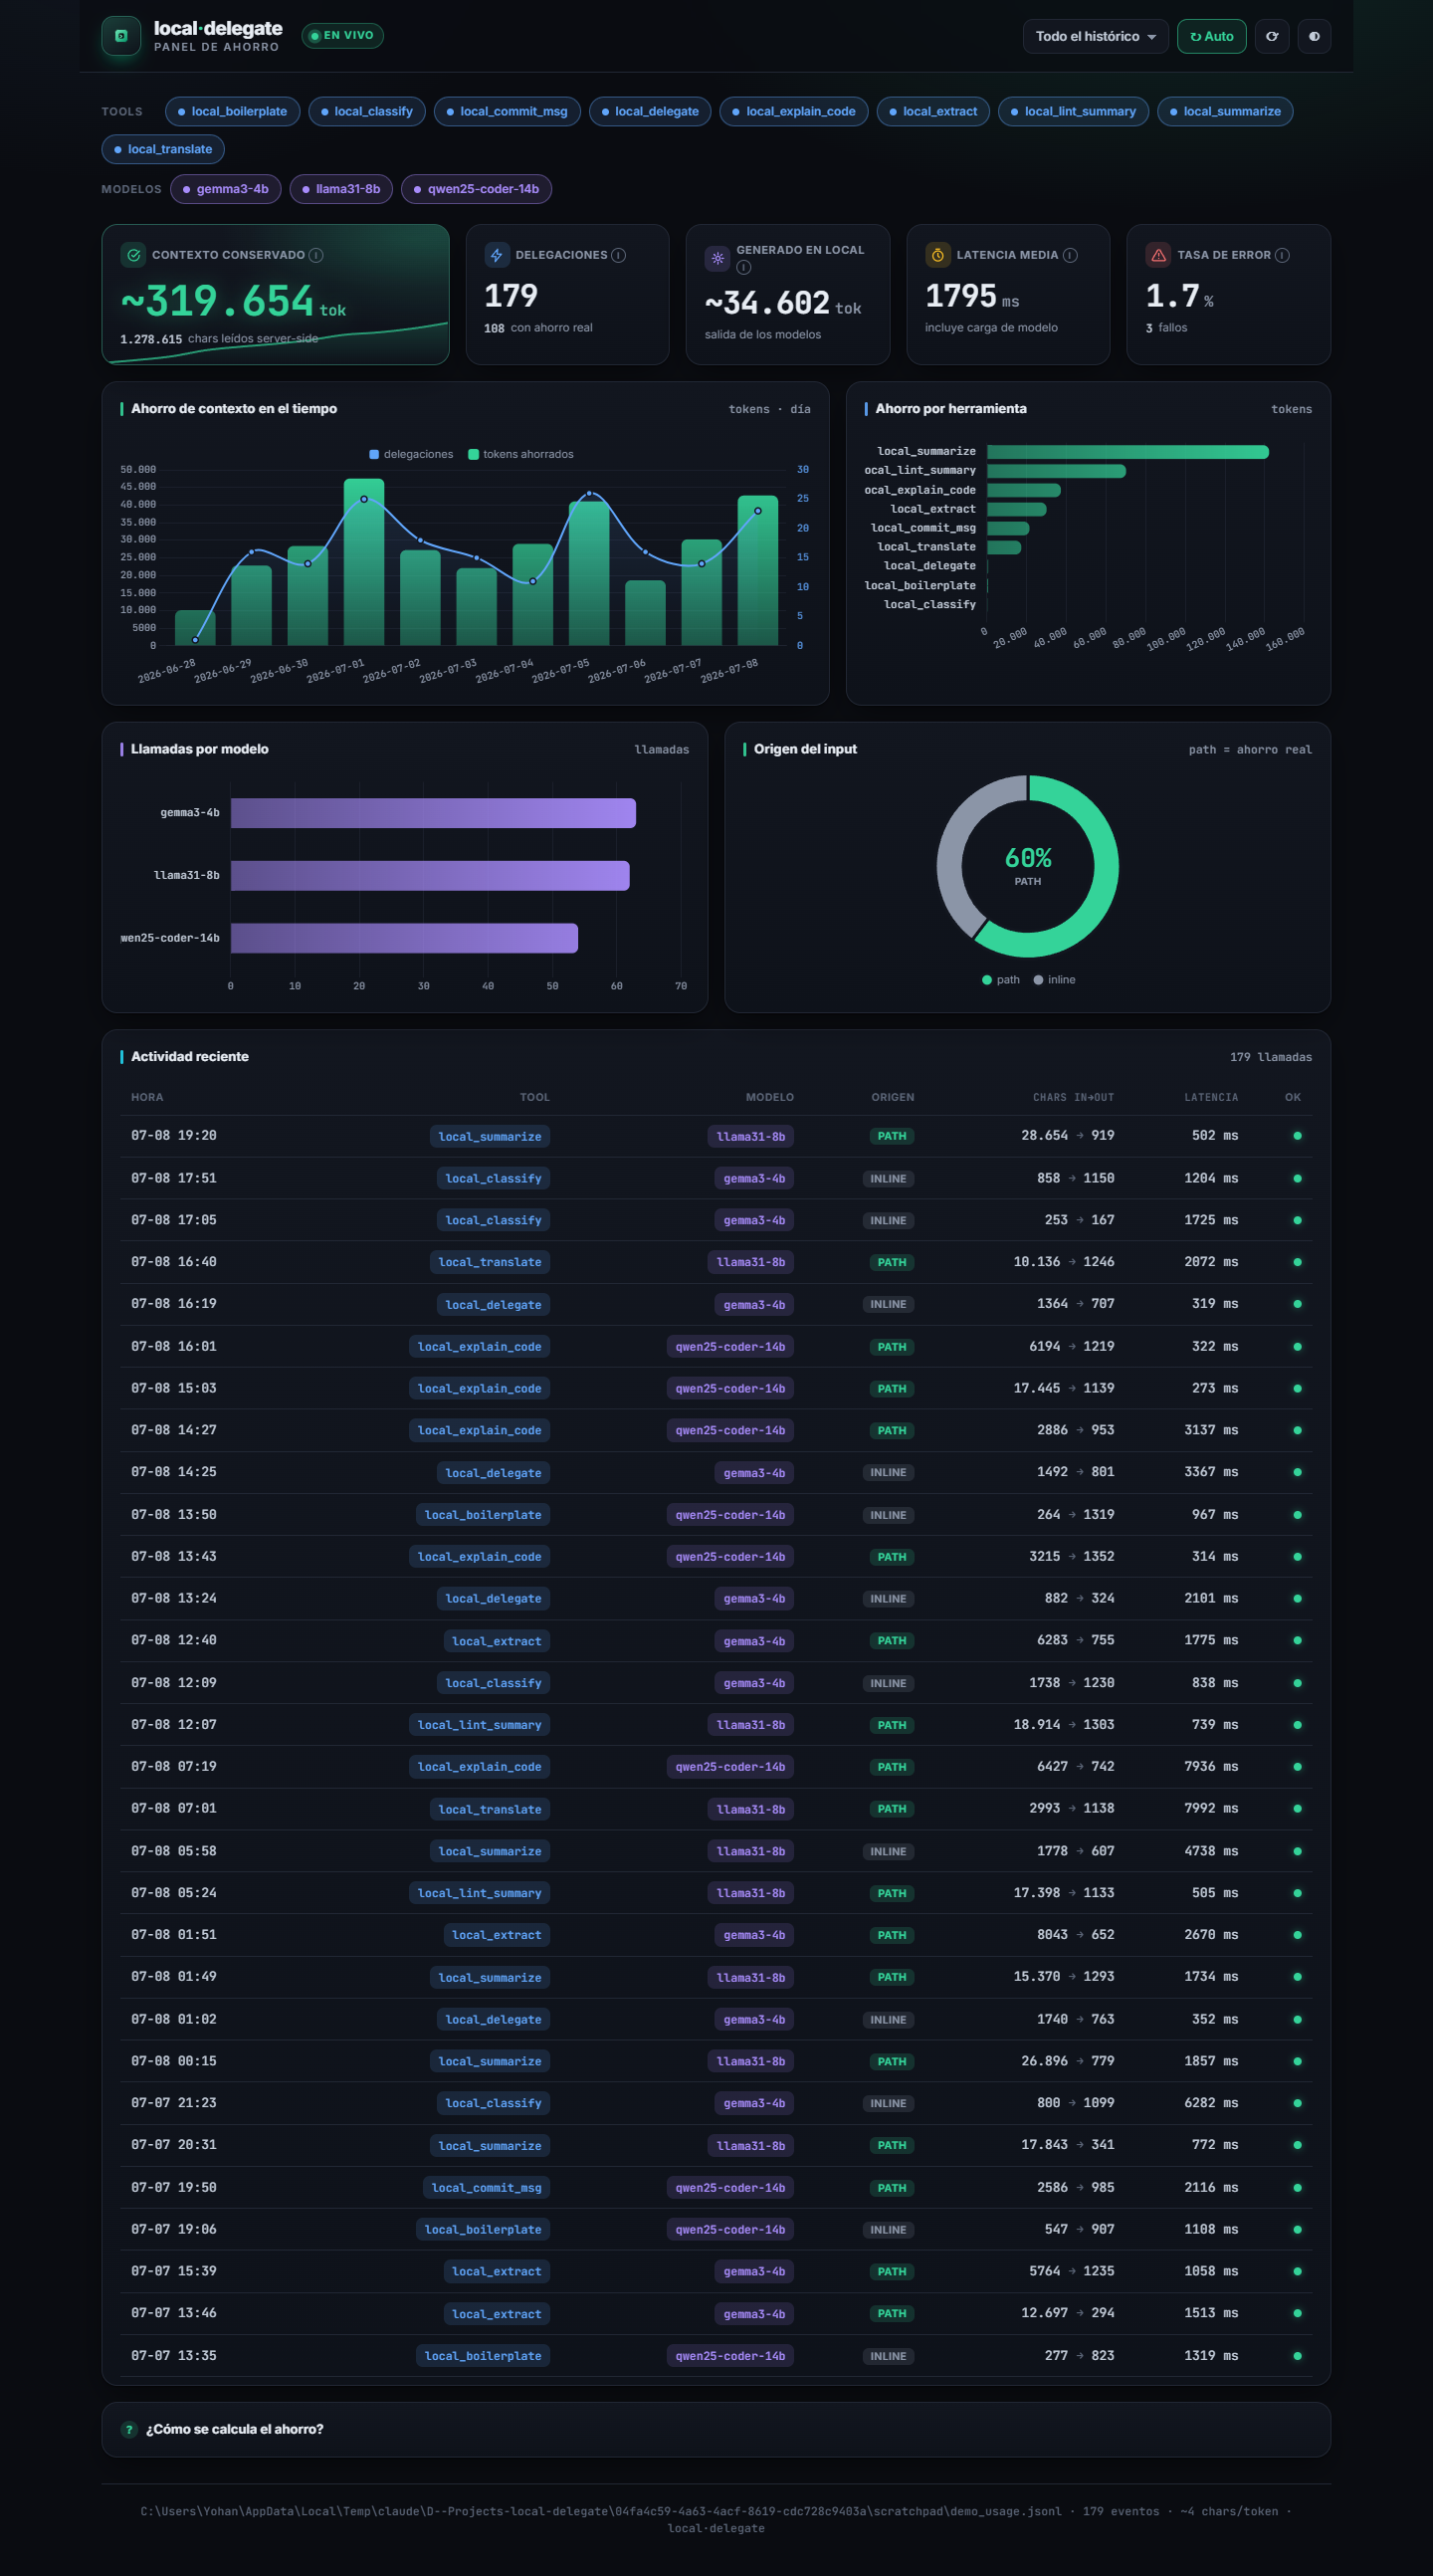
*嵌入式仪表盘(示例数据):本地后端状态(已安装模型、正在进行的委托、MCP工具)、系统RAM/VRAM及进程占用、节省的上下文令牌、按工具和模型计算的节省金额、分页显示的最近活动。在`http://127.0.0.1:9393`上提供。*
## 为什么?
当Claude需要总结大型日志、分类、提取字段或生成样板代码时,
会消耗您的订阅额度进行**机械**工作。`local-delegate`将这些任务暴露为
MCP工具,在本地LLM上运行:您传递`path`而不是`text`,服务器端读取文件,
大型内容**从不进入Claude的上下文**。只有简短的结果返回 — 您没有花费的额度。
## 快速安装
使用[`uv`](https://docs.astral.sh/uv/),无需安装任何内容:`uvx`下载并执行独立包。
将其添加到您的MCP配置(Claude Desktop / Claude Code):
```json
{
"mcpServers": {
"local-delegate": {
"command": "uvx",
"args": ["local-delegate-mcp"]
}
}
}
```
查看[`examples/`](./examples)中的完整模板。
## 要求
一个**与OpenAI兼容的端点**,已在`LOCAL_DELEGATE_BASE_URL`运行(默认为`http://127.0.0.1:9292/v1`)。任何服务端点均可:
- **llama-swap** — 查看[使用GPU Blackwell的示例](./docs/recipes/llama-swap-blackwell.md)。
- **Ollama** — `http://127.0.0.1:11434/v1`。
- **LM Studio**,**vLLM**,或任何支持OpenAI API的服务器。
该软件包**不启动**任何默认后端(`LOCAL_DELEGATE_AUTOSTART=0`)。llama-swap的自动启动是可选的(参见配置表)。
## 工具
传递`path`(而不是`text`)使MCP在服务器端读取文件 → 真正节省额度。
| 工具 | 功能 | 默认模型角色 |
|---|---|---|
| `local_summarize` | 总结文本或文件 | 机械 / 长(自动) |
| `local_classify` | 从列表中返回一个标签 | 机械 |
| `local_extract` | 提取字段 → JSON对象(使用`response_format`模式) | 机械 / 长(自动) |
| `local_boilerplate` | 根据规范生成代码 | 代码 |
| `local_delegate` | 文本→文本的通用转义 | 机械(或您传递的) |
| `local_lint_summary` | 总结lint/tests/CI日志 | 机械 / 长(自动) |
| `local_commit_msg` | 从差异生成提交消息 | 代码 |
| `local_translate` | 翻译文本或文件 | 机械 / 长(自动) |
| `local_explain_code` | 用散文解释代码 | 代码 |
| `local_describe_image` | 描述图像或回答图像相关问题(图像→文本) | 视觉 |
| `local_status` | 只读诊断:后端、目录、日志、VRAM、系统RAM | — (不调用聊天后端) |
本地模型**不**使用工具调用:服务器构建提示 + 防护栏,执行POST请求到端点并返回**仅文本**。
## 配置
所有内容均通过环境变量配置;无硬编码。默认模型ID仅为示例 —
您可以更改为后端模型的ID。
| 变量 | 默认值 | 描述 |
|---|---|---|
| `LOCAL_DELEGATE_BASE_URL` | `http://127.0.0.1:9292/v1` | 与OpenAI兼容的端点 |
| `LOCAL_DELEGATE_API_KEY` | *(空)* | Bearer令牌(如果您的端点需要) |
| `LOCAL_DELEGATE_TIMEOUT` | `180` | HTTP超时(秒) |
| `LOCAL_DELEGATE_LOG_DIR` | *(用户数据目录)* | 按月轮换的`usage-YYYYMM.jsonl`日志目录 |
| `LOCAL_DELEGATE_LOG` | *(空 = 启用轮换)* | 如果设置,则显式指定`usage.jsonl`日志文件路径(兼容性) |
| `LOCAL_DELEGATE_MODEL_MECHANICAL` | `gemma3-4b` | 用于分类/提取/短总结的模型 |
| `LOCAL_DELEGATE_MODEL_LONG` | `llama31-8b` | 用于长文档的模型 |
| `LOCAL_DELEGATE_MODEL_CODE` | `qwen25-coder-14b` | 用于代码的模型 |
| `LOCAL_DELEGATE_MODEL_FAST` | `qwen35-2b` | 超快速 / 琐碎模型 |
| `LOCAL_DELEGATE_MODEL_VISION` | `qwen3-vl-8b` | 用于`local_describe_image`的视觉模型 |
| `LOCAL_DELEGATE_MAX_IMAGE_MB` | `8` | `local_describe_image`的图像大小限制 |
| `LOCAL_DELEGATE_LONG_INPUT_CHARS` | `6000` | 机械↔长输入的阈值 |
| `LOCAL_DELEGATE_JSON_SCHEMA` | `auto` | `local_extract`的`response_format`模式:`auto`/`on`/`off` |
| `LOCAL_DELEGATE_FEEDBACK` | `1` | 当`source=path`时,在结果中附加节省信息(`0`禁用) |
| `LOCAL_DELEGATE_ALLOWED_DIRS` | *(空 = 无限制)* | `path`的允许根目录,以`;`分隔 |
| `LOCAL_DELEGATE_WEB` | `1` | 嵌入式指标网页(`0`禁用) |
| `LOCAL_DELEGATE_WEB_HOST` / `_PORT` | `127.0.0.1` / `9393` | 网页的主机/端口 |
| `LOCAL_DELEGATE_AUTOSTART` | `0` | llama-swap的自动启动(可选) |
| `LLAMASWAP_EXE` / `LLAMASWAP_CONFIG` / `LLAMASWAP_LISTEN` | — | 仅当`AUTOSTART=1`时 |
## 节省指标
MCP记录每次调用到一个按月轮换的日志中,并在
`http://127.0.0.1:9393`提供一个**仪表盘**,具有范围选择器和正在进行的委托的可视化功能。
*上下文节省* = 服务器端读取的输入字符(`source=path`调用)÷ 4(或后端给出的实际令牌)≈ 从未进入Claude上下文的令牌。详细信息请参见[wiki](./docs/wiki/Home.md)。
## 范围 / 非目标
`local-delegate`故意设计为**文本/图像→文本**:构建提示(或多模态有效载荷),
执行POST请求到`/chat/completions`并仅返回文本。**不**做以下事情:
- **本地工具调用。** 本地模型不调用工具或执行代码;
Claude仍然负责此操作。添加此功能会使此软件包成为并行编排器,
这不是目标。
- **图像生成或编辑。** `local_describe_image`仅用于图像→文本
(描述、读取可见文本、回答特定问题);不生成或编辑图像。
- **音频。** 对于转录,请使用配套
[`whisper-transcribe-mcp`](https://github.com/ZahiriNatZuke/whisper-transcribe-mcp),
而不是尝试将音频塞进这里。
- **取代订阅。** 目标是通过委托有限的机械步骤来节省额度,
而不是将所有工作路由到本地模型。
## Claude Code钩子(可选)
包含两个建议在合适时机委托而不阻塞原始工具的钩子
(`PreToolUse`/`Read`用于大文件,`PostToolUse`/`Bash`用于lint/tests的长输出):
[`docs/recipes/claude-code-hooks.md`](./docs/recipes/claude-code-hooks.md)。
## llama-swap组(可选)
使用`pip install "local-delegate-mcp[llamaswap]"`,可使用两个CLI管理
llama-swap**组**(一个常驻模型 + 一个轮流使用的池),并内置VRAM和**系统RAM**防护( `--ram-gb`可选):
```bash
local-delegate check-llamaswap --config config.yaml --vram-gb 16 --ram-gb 32
local-delegate init-llamaswap --config config.yaml --resident gemma3-4b --swap llama31-8b,qwen25-coder-14b --vram-gb 16 --ram-gb 32
```
该软件包**从不**擅自修改您的`config.yaml` — 这些命令仅在您调用时运行。
`init-llamaswap`在写入之前运行防护措施(如果不符合要求,则不写入),
并且从不覆盖配置文件(除非使用`--force`)。详细信息、完整的语义验证和应用仪式请参见
[`docs/recipes/llama-swap-groups.md`](./docs/recipes/llama-swap-groups.md)。
## 链接
- [Wiki](./docs/wiki/Home.md) · [Recipes](./docs/recipes)
- [CONTRIBUTING](./CONTRIBUTING.md) · [CODE OF CONDUCT](./CODE_OF_CONDUCT.md) · [CHANGELOG](./CHANGELOG.md)
- [MIT License](./LICENSE)
 MCP 市场
