内容
# audient
**用于智能体的实验性音频感知层**:持续聆听、事件门控、多层分类和动态记忆。
大型语言模型(LLMs)原生处理文本。当音频是语音时,它们通过转录或音频原生模型来处理。但它们无法感知其他音频内容——比如窗外鸟儿的歌声、另一间房间玻璃破碎的声音或烟雾报警器的响声。audient 为智能体提供了耳朵,可以使用专用模型和推理来检测和分类音频事件。
在底层,它是一个 **MCP 服务器**(stdio + HTTP,地址为 `/mcp`)加上 `127.0.0.1:8089` 上的 **FastAPI REST + WS + SSE 适配器**。您可以使用支持 MCP 的智能体(Claude Desktop、`fast-agent`)驱动它,通过 HTTP/SSE 端点访问知识,或运行捆绑的 [`frontend/`](frontend/) UI 以实时查看循环并在浏览器中关闭它。
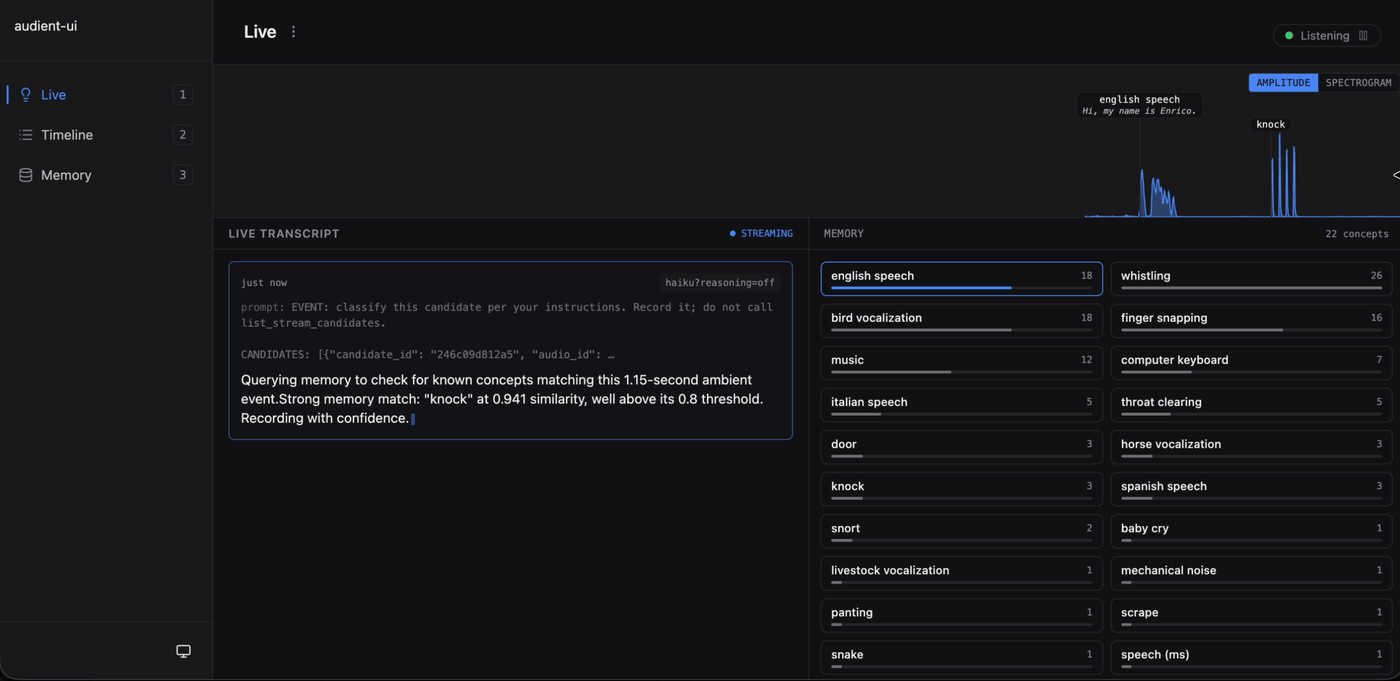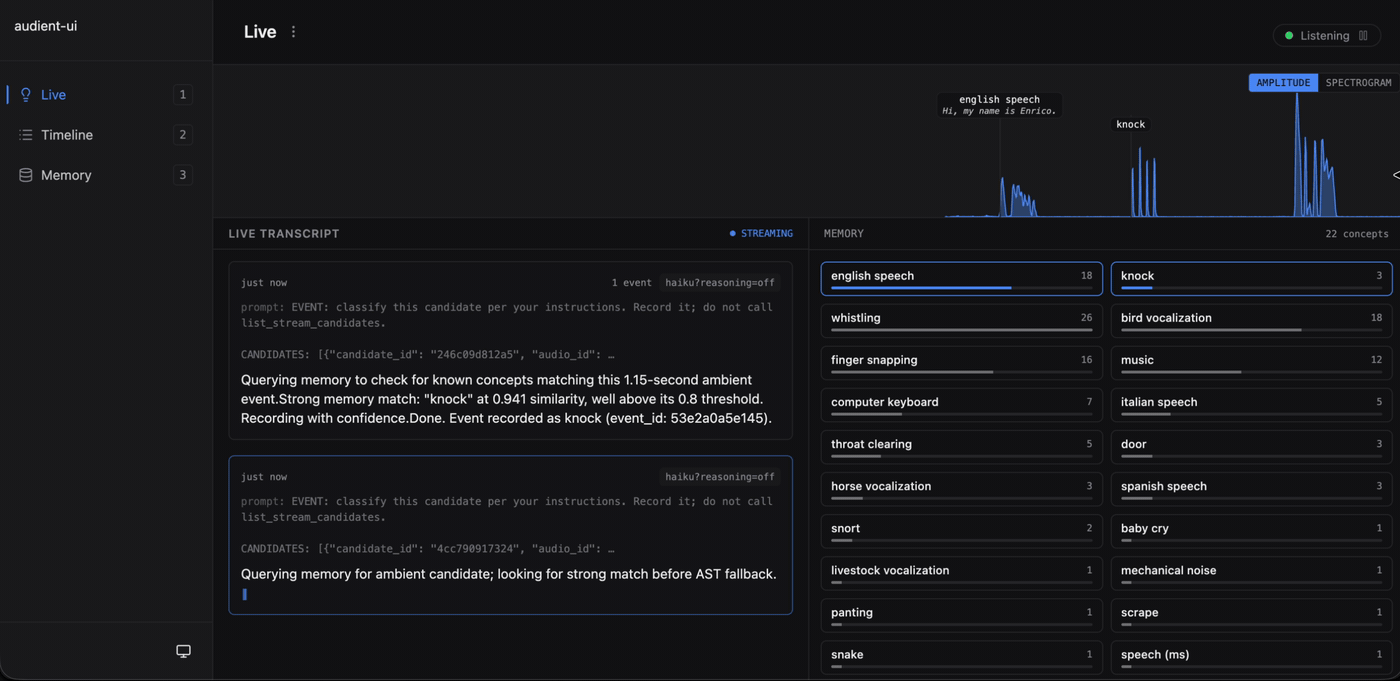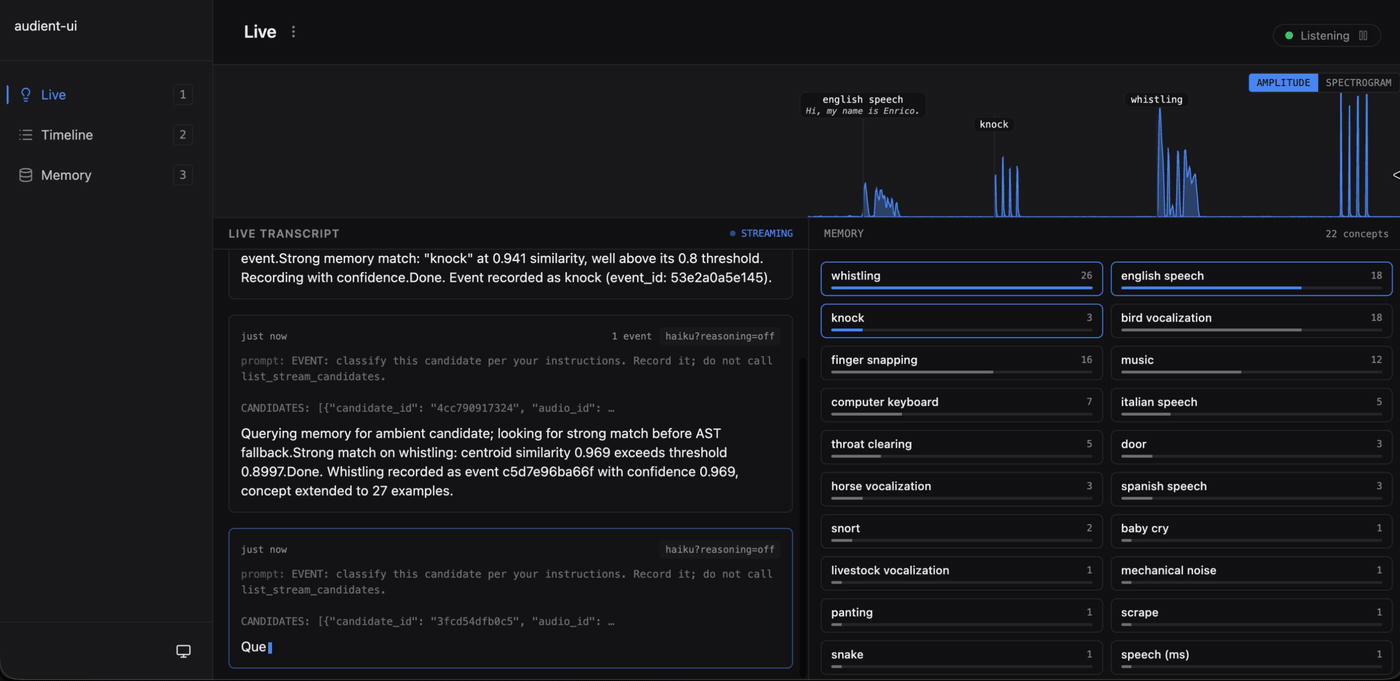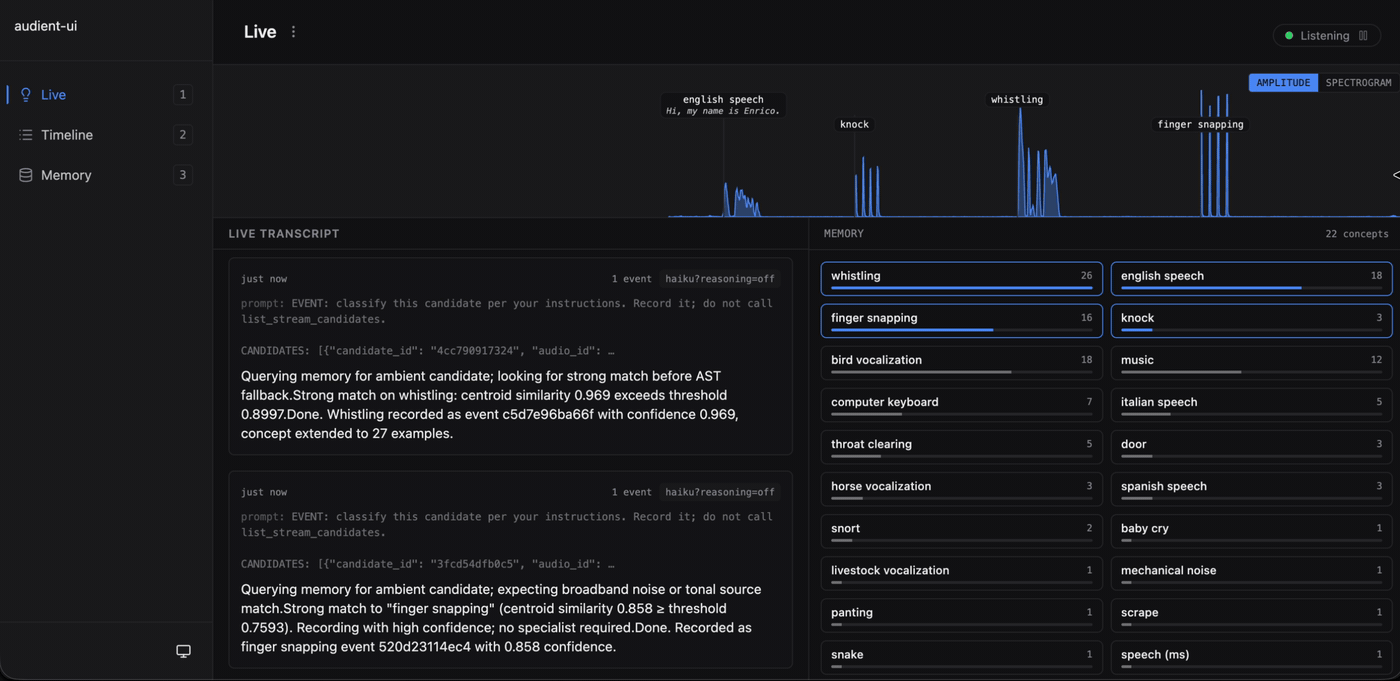
有关设计背后的故事、生物学平行和增长循环的演练,请参阅 [Let the AI Out: audient — an ambient audio perception layer that grows](https://es617.dev/2026/07/07/audient-ears/)。90 秒演示内存从空到实时自动识别的视频:[YouTube 上的演示](https://www.youtube.com/watch?v=6ofyj-2gQ8c)。
## 音频实际需要什么
仅将音频视为语音的智能体错失了音频的大部分内容。今天,它无法获取的有用信息包括:
- **环境感知** — 智能体周围正在发生的事情。另一个房间的音乐、走廊的脚步声、暖通空调的开启。
- **事件检测** — 警报、门铃、两层楼下响起的电话、玻璃破碎、婴儿哭泣。
- **语音 beyond 词汇** — 通话中语音的压力、语调变化、实际说话的人、会议的背景。
- **异常检测** — 设备刚刚改变了音调。宠物听起来不同。隔壁的施工昨天不存在。
这些都有专门的模型。问题不在于模型,而在于编排:今天,您需要决定在哪个剪辑上运行哪个模型,并自己将答案拼接起来。智能体没有参与这个过程。
该项目旨在创建一个始终开启音频通道的智能体。它决定了值得关注的内容,识别它以前听过的声音,将其他内容升级到合适的专家,并学习它不知道的事情。长远来看,这是一个可以自行部署新专家并最终训练它们的智能体。
## 四个阶段
```
持续音频
│
▼
┌─────────────────────────────────────┐
│ 门控 │
│ 能量 / 新颖性 / VAD │
└──────────────┬──────────────────────┘
▼
┌─────────────────────────────────────┐
│ 指纹 │
│ CLAP 嵌入 + 符号特征 │
└──────────────┬──────────────────────┘
▼
┌─────────────────────────────────────┐
│ 记忆 (top-k cosine) │
└──┬──────────────────────────────┬───┘
│ 强匹配 │ 弱匹配 / 错过
│ ▼
│ ┌─────────────────────────────┐
│ │ 智能体 │
│ │ AST 粗分类 (+ 光谱) │
│ │ → 专家如果 AST 提示 │
│ │ 在已知领域 │
│ │ (例如 Whisper、BirdNET) │
│ └─┬───────────────────────┬───┘
│ │ 识别 │ 无匹配
▼ ▼ ▼
┌──────────────────────────┐ ┌──────────────┐
│ 记录事件 │ │ 未处理 │
│ (扩展内存) │ └──────┬───────┘
└──────────────────────────┘ │ 标签
▼
(记忆)
```
该流程大致模仿人类听觉的工作方式。
1. **门控** — `detect_events`、`vad`、能量/新颖性/光谱分割。修剪连续信号到候选区域。大多数音频永远不会到达系统的其余部分。(听觉:耳蜗 + 脑干放大起始和瞬态,衰减稳定背景。)
2. **指纹** — 每个候选者都获得 CLAP 嵌入(密集、可比较)加上符号特征面板(光谱中心、峰值与突出度、谐波、噪声底限、主电源嗡鸣、剪辑、时间稳定性)。嵌入用于检索;符号特征是智能体以纯英语读取和推理的内容。(听觉:初级听觉皮层将信号转换为下游区域可用的表示。)
3. **识别** — sqlite-vec 顶级 k 余弦在学习概念上。针对校准概念的强匹配 → 服务器端标记。对于错过,智能体使用 AST(527 标签的 AudioSet 分类器)作为广泛路由,有时还使用光谱特征进行消歧。AST 很粗糙 — 智能体在 AST 提示已知领域时,会链接一个狭窄的专家(例如 Whisper 用于语音,BirdNET 用于鸟鸣声;集合是任意的)。(听觉:专用区域 — 语音、音乐、环境声音 — 并行查看指纹,每个都有自己的记忆;“识别”是在哪里亮起的。)
4. **未处理** — 如果没有任何东西识别它,事件将以系统认为它听到的内容放入 `list_unhandled`。某人(智能体或人)通过 `label_unhandled` 一次标记它;该标签成为一个概念;下次内存检查匹配时。(听觉:你无法识别它;你查看源或询问。一旦你有标签,你就会在下次识别它。)
智能体始终 *感知* — 每个事件在发生时都会流出,无论它产生在哪个阶段。变化的是 *分类* 的对象:服务器用于强内存匹配(便宜,无 LLM 调用),智能体用于其他所有情况。
第一阶段还具有 **语音快速通道**。Silero VAD 与能量/新颖性分割并行运行;当它触发时,区域跳过 CLAP → 内存 → 专家路由,直接进入 Whisper。如果 Whisper 返回转录,则事件直接记录为语音。如果 Whisper 返回无用的内容(沉默或被 VAD 误导的非语音音频 — 音乐、动物叫声、持续音调),则区域进入与所有其他内容相同的环境分类器路径;不会静默丢弃任何音频。
## 三种音频推理方式
**智能体在符号表示上推理,从不处理原始音频。** 暴露了三个层次供其推理:
- **信号。** `summarize`、`spectrum`、`stats` 返回纯数字 — RMS、信噪比、噪声底限、光谱中心、滚降、带宽、平坦度、顶部光谱峰值与突出度(以 dB 为单位)、谐波比率、过零率、主电源谐波、峰度、剪辑和时间稳定性块。智能体以 JSON 读取这些内容,并像音频工程师一样推理。
- **嵌入。** 智能体从未看到 CLAP 矩阵本身。它看到的是与内存中概念的相似性得分 — `query_memory` 返回顶级 k 匹配的余弦相似性、阈值和识别器类型。
- **标签。** 专家返回结构化标签。Whisper 转录。BirdNET 物种与置信度。AST 在 527 个类别上的粗略猜测。智能体通过 `invoke_specialist` 传递声音,并读取带有用于解释的纯英语契约的结构化答案。
智能体可以不同意任何单一层 — 如果标签建议不同的类别,则覆盖嵌入相似性;如果信号特征不匹配,则覆盖专家。没有任何单一层是权威的。
## 安装
### 从 PyPI(通常路径)
需要 macOS 或 Linux 上的 Python 3.12 或 3.13。轮包同时包含服务器和浏览器 UI,因此一次安装即可获取所有内容。
```bash
pip install audient
export ANTHROPIC_API_KEY=sk-... # 仅适用于 --classifier=internal(默认)
audient --no-stdio
```
然后打开 <http://127.0.0.1:8089/> 并授予麦克风权限。首次运行时会从 Hugging Face 下载约 600MB 的模型权重;冷缓存预计需要 20-40 秒的预热时间。
跳过 API 密钥,运行服务器时不使用内置分类器(仍可使用内存优先的快速路径):
```bash
audient --no-stdio --classifier=external
```
### 从源码(开发工作流)
克隆 + `make demo` 以实现具有 Vite 热重载和服务器的双进程开发设置。
```bash
git clone https://github.com/es617/audient
cd audient
(cd server && uv sync)
(cd frontend && pnpm install)
export ANTHROPIC_API_KEY=sk-...
make demo
```
服务器在 `:8089` 上运行,Vite 开发服务器在 `:5173` 上运行。打开 <http://localhost:5173/> 以获取热重载 UI。对于服务器端烟雾测试、无头麦克风模式或运行模式矩阵,请参阅 [`server/README.md`](server/README.md#run-modes);对于每个表面前端演练,请参阅 [`frontend/README.md`](frontend/README.md)。
## 从 Claude Code(或任何 stdio MCP 客户端)驱动 audient
默认入口点(`uv run audient`)使用 stdio MCP,这是 Claude Code 和大多数 MCP 主机所消费的。将其添加到您的客户端配置中:
```json
{
"mcpServers": {
"audient": {
"command": "uv",
"args": ["--directory", "/absolute/path/to/audient/server", "run", "audient"]
}
}
}
```
智能体获取完整的 MCP 工具表面 — `load_audio`、`summarize`、`spectrum`、`detect_events`、`vad`、`invoke_specialist`、`query_memory`、`record_event`、`teach`、`list_unhandled`、`label_unhandled` 等。工具调用在服务器端进行,并修改 SQLite 概念内存。
有几个需要注意的事项:
- **Claude Code 不显示 MCP 服务器通知。** 协议支持 `ResourceUpdatedNotification`(audient 在新事件/候选项上触发),但 Claude Code 的 UI 不会将它们渲染为对话消息。要查看“自上次询问以来发生了什么”,请让智能体调用 `list_events` 或 `list_stream_candidates`。
- **捆绑的前端仍然可以并行工作。** `127.0.0.1:8089` 上的 FastAPI / SSE 适配器是同一进程的一部分。因此,Claude Code 编写的任何内容(新事件、更正的标签、教授的概念)都会在前端时间轴上实时显示。两个客户端驱动同一个服务器;只有 Claude Code 对实时推送不可见。
## 已知限制
audient 是实验性的。它在开发过程中已经在录制的数据上进行了轻微的评估;尚未进行正式的基准测试或公共数据集评估。其他限制:
- **单一源假设。** 管道将每个检测到的区域视为一个事件。重叠的声音 — 鸟鸣声与音乐同时播放,门铃在对话中响起 — 被分类为嵌入主导或 VAD 快速通道获胜的信号。非主导事件丢失。源分离未启用。
- **macOS优先。** 所有内容都在 macOS 上进行了测试。依赖项(torch、transformers、faster-whisper、sounddevice/portaudio)都有 Linux 轮,因此 Linux 应该可以 minimal fuss 运行;但我尚未验证。Windows 需要在 `pyproject.toml` 中的 BirdNET 依赖门控中添加 Windows 分支,可能还需要检查麦克风源路径;模型本身不受 Windows 兼容性影响。WebSocket `/ingest` 端点和捆绑前端的浏览器麦克风捕获是平台无关的,因此 Windows 用户可以通过浏览器驱动 audient — 后端是摩擦力。
- **为Anthropic调整分类器提示。** 进程内分类器通过 [fast-agent](https://github.com/Evalstate/fast-agent) 运行,因此任何支持的提供者(Anthropic、OpenAI、Gemini、Ollama-local)都将执行,但提示是针对 Claude 模型编写和验证的。切换提供者可能需要调整提示。
## 致谢
audient 建立在许多其他人的工作基础上。承载负载的部分:
- **MCP + 智能体基础设施** — [FastMCP](https://github.com/jlowin/fastmcp)(Jeremiah Lowin),[fast-agent](https://github.com/Evalstate/fast-agent)(Shaun Smith / Evalstate)。
- **模型** — [LAION-CLAP](https://github.com/LAION-AI/CLAP) 用于音频嵌入;[AST](https://github.com/YuanGongND/ast)(Yuan Gong 等)作为 AudioSet 粗分类器;[Whisper](https://github.com/openai/whisper)(OpenAI)通过 [faster-whisper](https://github.com/SYSTRAN/faster-whisper);[BirdNET](https://github.com/kahst/birdnetlib)(康奈尔鸟类学实验室)通过 birdnetlib;[Silero VAD](https://github.com/snakers4/silero-vad)。
- **模型托管** — [Hugging Face](https://huggingface.co/) + `transformers` 用于 CLAP 加载。
- **存储** — [sqlite-vec](https://github.com/asg017/sqlite-vec)(Alex Garcia)。
- **音频基础设施** — librosa、soundfile、sounddevice。
- **UI**([`frontend/`](frontend/))— React、Vite、Tailwind、TanStack Query、shadcn/ui、Zustand。
## 许可证
Apache License 2.0 — 请参阅 [LICENSE](LICENSE)。
 MCP 市场