

内容
<div align="center">
# 可审计
**`可审计` 是一个开源的 AI 智能体决策记录系统:它捕获每个决策的依赖关系,实时回放并在决策不再成立时回滚已提交的操作。**
*您的日志显示智能体做了什么。`可审计` 显示它依赖于什么,在实时状态下回放,并在其不再成立时回滚。*
[](https://pypi.org/project/auditable/)
[](https://pypi.org/project/auditable/)
[](LICENSE)
[](https://github.com/yzhao062/auditable)
[比较](#可审计vs您已经使用的工具) · [旗舰演示](#旗舰时刻) · [接入您的智能体](#接入您的智能体) · [生命周期](#生命周期) · [安装](#安装) · [文档](https://auditable-ai.readthedocs.io/) · [路线图](#路线图)
</div>
### 可审计 vs. 您已经使用的工具
| 功能 | **可审计** | 追踪和可观察性<br><sub>[LangSmith](#ref-1), [Langfuse](#ref-2), [Phoenix](#ref-3)</sub> | 评估框架<br><sub>[DeepEval](#ref-5), [Ragas](#ref-6), [promptfoo](#ref-7)</sub> | 护栏<br><sub>[NeMo](#ref-9), [Guardrails AI](#ref-10), [Lakera](#ref-11)</sub> |
|---|:---:|:---:|:---:|:---:|
| 捕获决策依赖状态 | ✅ | 🟡 | ❌ | ❌ |
| 在实时状态下重新决策(回放) | ✅ | 🟡 | ❌ | ❌ |
| 撤销已提交的操作(回滚) | ✅ | ❌ | ❌ | ❌ |
| 跨计划、运行和评估的统一图 | ✅ | 🟡 | ❌ | ❌ |
| 框架无关、核心无依赖 | ✅ | 🟡 | 🟡 | 🟡 |
<sub>✅ 是 · 🟡 部分 · ❌ 否,根据每个工具的公开文档(2026)。这些类别与 `可审计` 互补,而不是竞争关系:追踪捕获执行,评估衡量质量,护栏在运行时阻止。`可审计` 是审计和恢复层,可以与它们结合使用。参见 [参考文献](#参考文献)。</sub>
**`可审计` 是唯一具有完整功能的列。** 它有什么新特点:
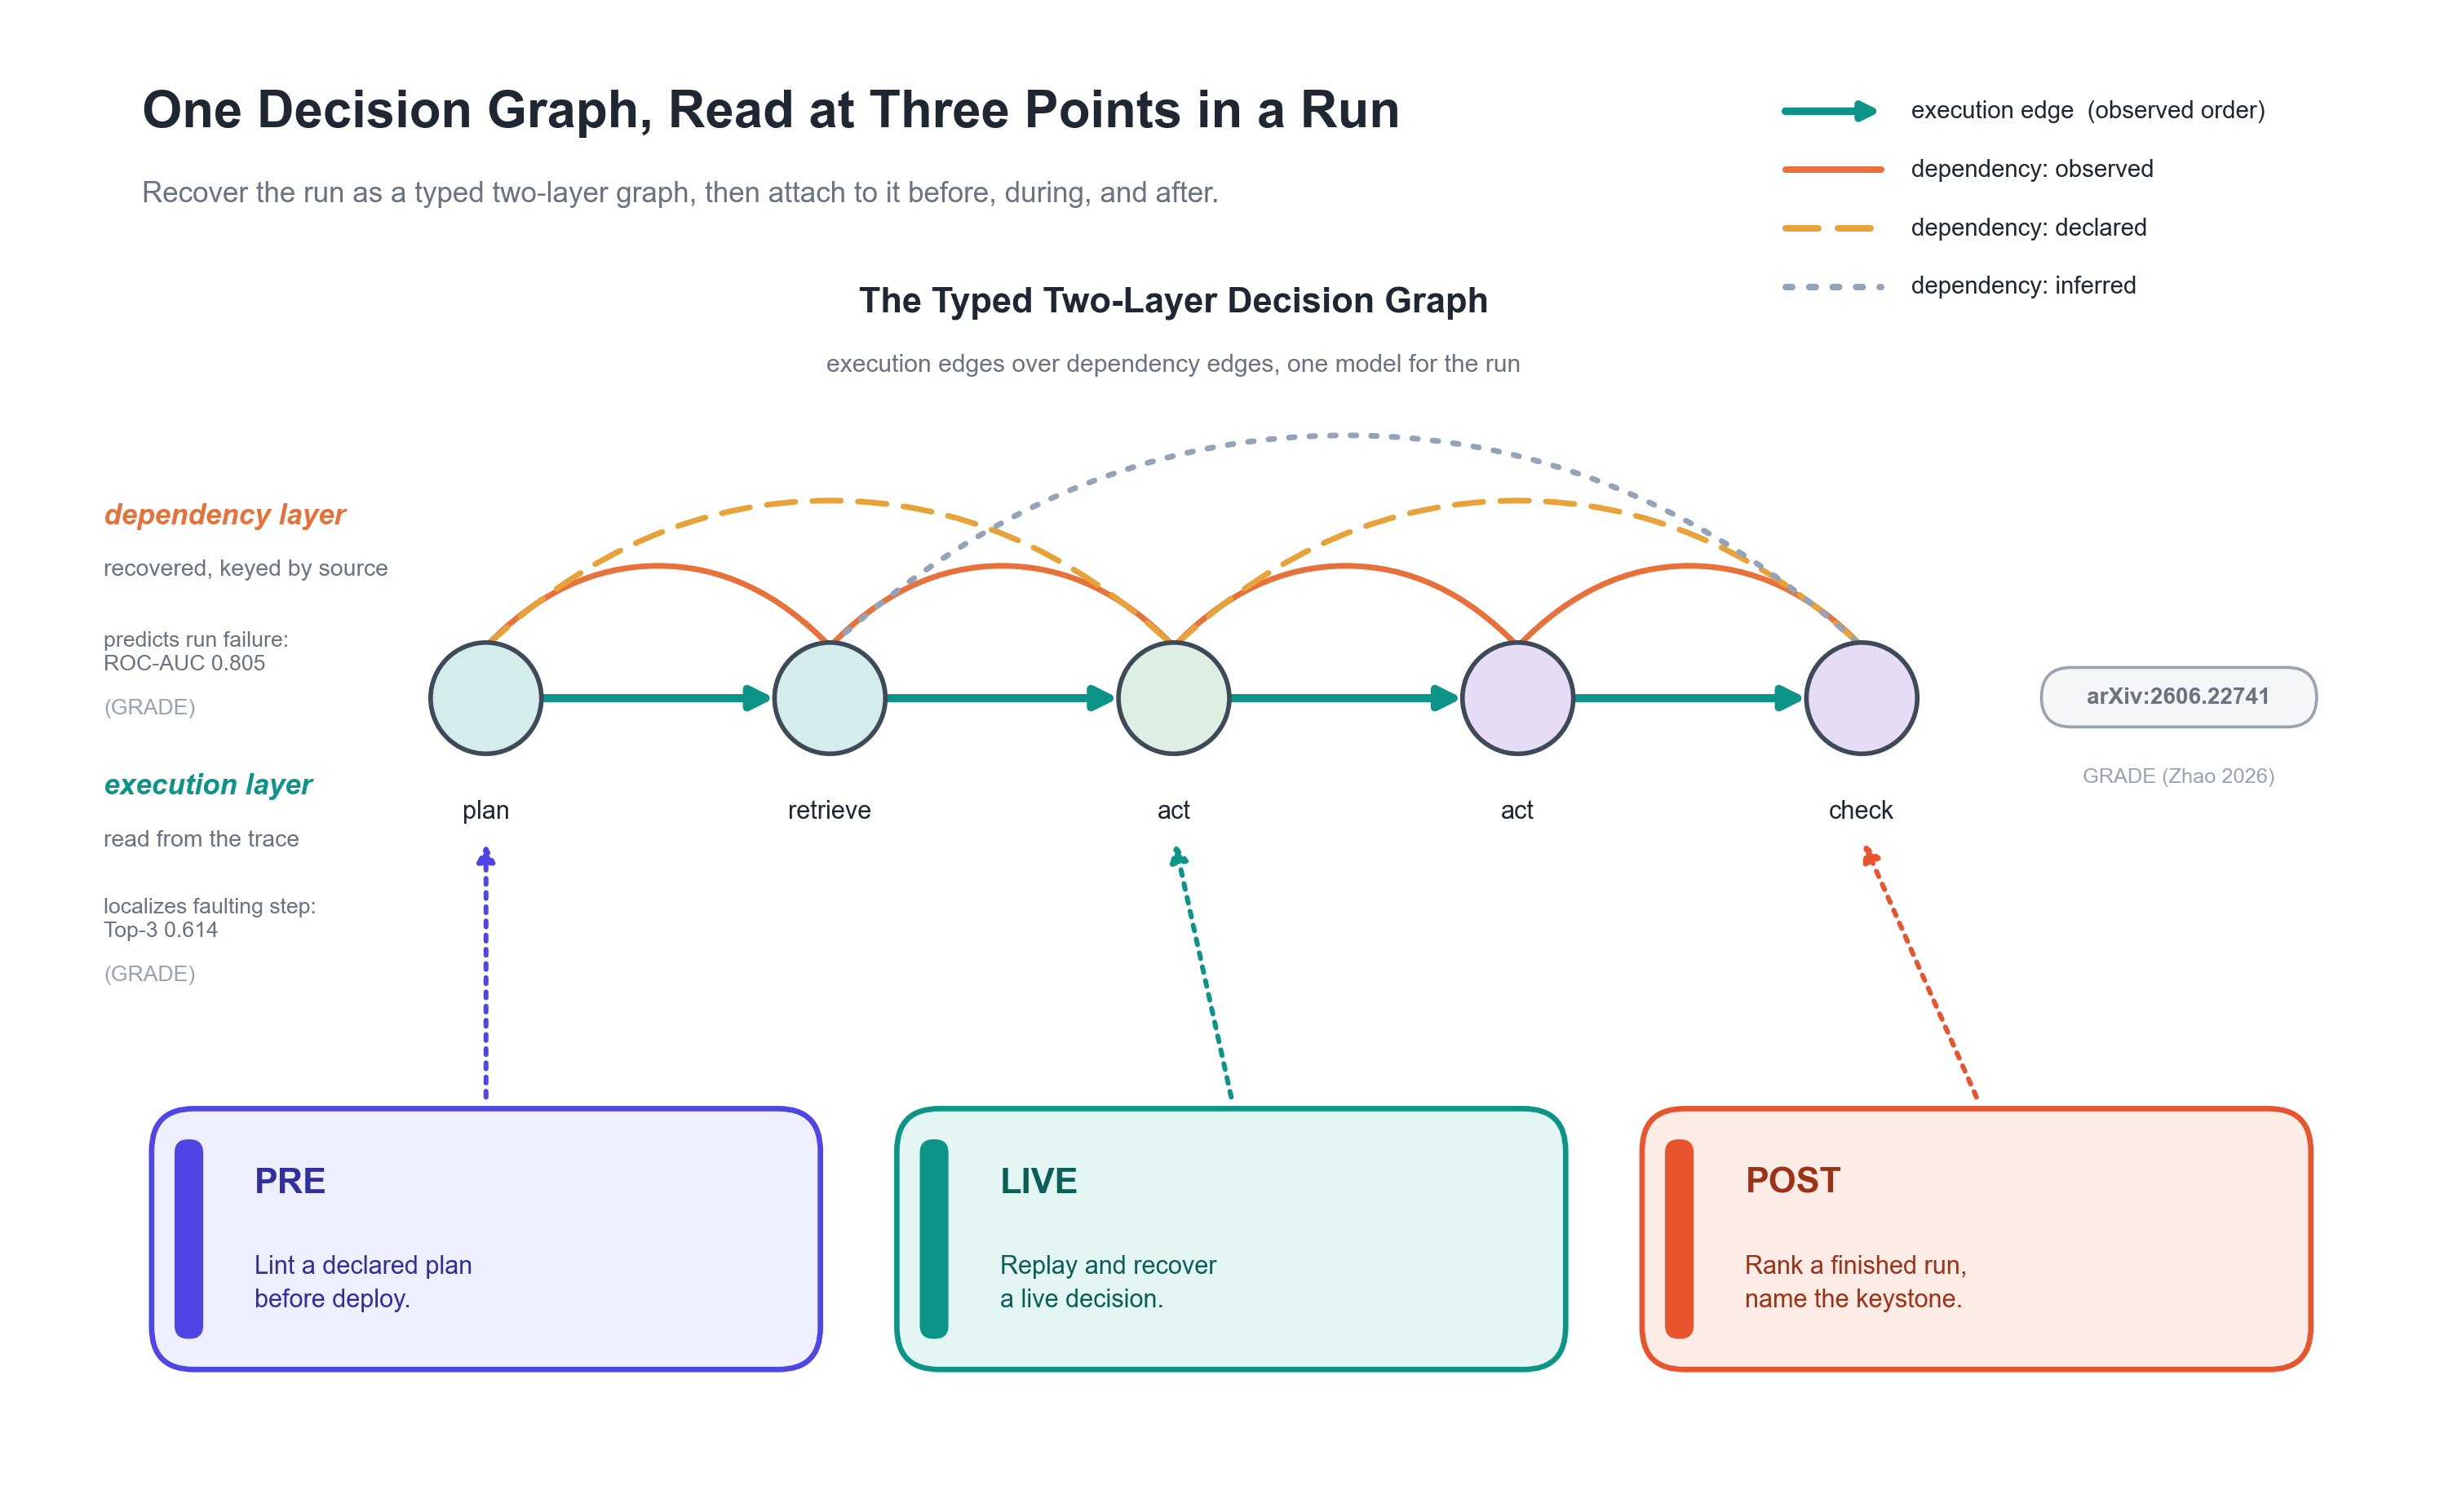
- **统一的 AI 智能体图表示。** 每个智能体运行都成为一个有类型的图,PRE、LIVE 和 POST 都读取它。从计划到实时运行再到评估,使用一个表示,而不是三个独立的工具。
- **恢复,而不仅仅是观察。** `可审计` 捕获决策的依赖状态,在实时状态下回放,并通过补偿措施在决策不再成立时撤销已提交的操作。日志记录告诉您出了什么问题;`可审计` 会撤销它。
- **一个决策,三个阶段,共同评估。** 数据、模型和框架绑定在一个签名、哈希链接的记录中,因此一个决策作为一个单元进行审计,而不是三个独立的日志。
### 在公开的智能体基准测试中得到验证
该图不仅仅是结构。在六个公开的智能体数据集(GRADE,[arXiv:2606.22741](https://arxiv.org/abs/2606.22741))中,依赖层预测哪些运行失败,**ROC-AUC 0.805**,而运行长度没有信号,执行层将故障步骤定位在 **Top-3 0.614**。查看 [基准测试详情](docs/post-analysis.md) 获取完整的数据和数据集。
<p align="center">
<img src="https://raw.githubusercontent.com/yzhao062/auditable/main/assets/grade-transfer.png" alt=" leave-one-corpus-out 转移 ROC-AUC:依赖信号在所有六个保留的智能体数据集上超过随机猜测,而运行大小在 tau-bench 和 SWE-Gym 上低于随机猜测" width="49%">
<img src="https://raw.githubusercontent.com/yzhao062/auditable/main/assets/grade-localization.png" alt=" 步骤级故障定位:按执行图结构对步骤进行排名,在 top-1、top-3 和 MRR 上优于早期故障位置" width="49%">
</p>
<p align="center"><sub>来自 GRADE 的图表(<a href="https://arxiv.org/abs/2606.22741">arXiv:2606.22741</a>)。</sub></p>
智能体根据依赖状态运行,而依赖状态可能会悄悄变化。几分钟前读取的预算可能会低于已经提交的金额;计划时固定的价格可能会在行动落地前发生变化。大多数工具记录了发生了什么,但它们无法根据当前的实时状态重新决策,因此过时的决策将持续到人类注意到它为止。`可审计` 在一个图上填补了这个恢复空白:它捕获决策,在实时状态下回放,并在其不再成立时撤销已提交的操作。
## 旗舰时刻
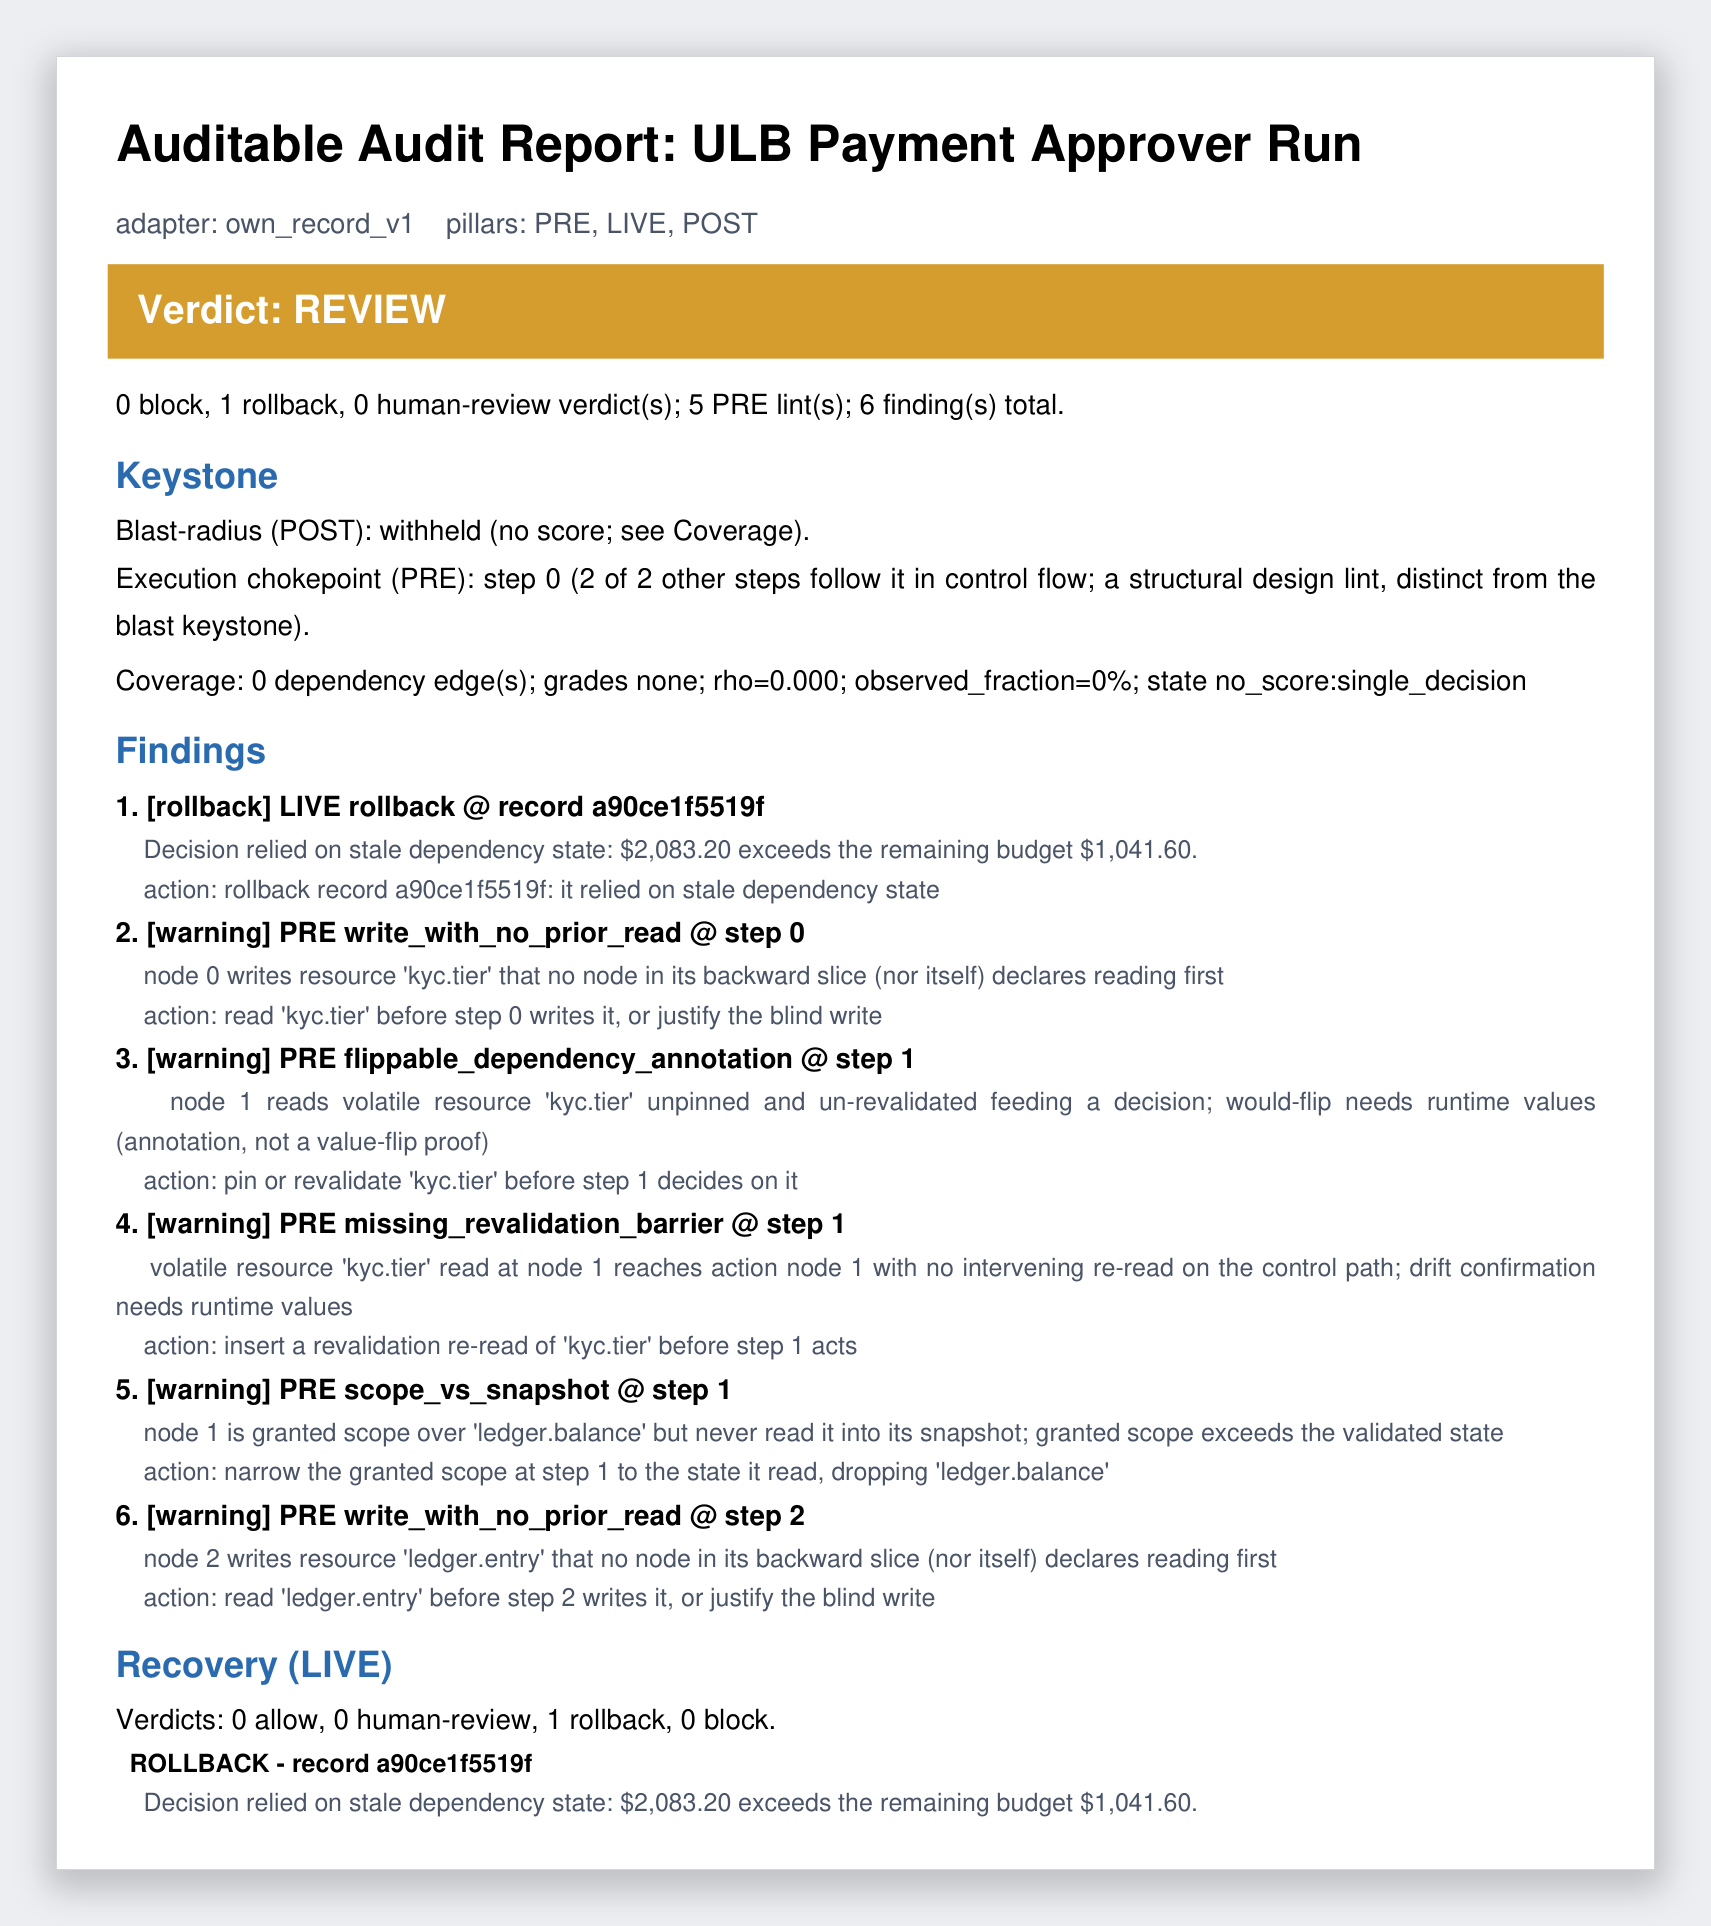
一个支付案例,通过 `可审计` 的整个生命周期,18 次调用。智能体批准了一笔 2083.20 美元的供应商支付,基于一个涵盖该金额的预算快照。六天后,实时预算已低于该金额。`replay` 在实时状态下重新决策,闸门撤销了已提交的支付。这是一种恢复,而不是一行日志记录。
```bash
pip install "auditable[graph]"
python examples/example_end_to_end.py
```
运行打印一份审计报告:一个 REVIEW 判决,关键节点及其覆盖原因,六个发现带有严重性标签和推荐操作,以及撤销支付的 LIVE 恢复。将它粘贴到拉取请求或问题中。
## 接入您的智能体
`可审计` 与您已经运行的智能体配合使用。将 LangGraph `StateGraph` 的普通同步或异步函数节点封装在 TypedDict 状态中,每个节点的读取和写入操作都成为 **观察到的** 依赖边,跨越超级步骤屏障,无需更改节点逻辑:
```python
from langgraph.graph import StateGraph
from auditable import analyze_run
from auditable.integrations.langgraph import instrument
builder = instrument(StateGraph(State)) # 1) 封装一次,然后像往常一样构建/编译/调用
...
graph = builder.compile()
graph.invoke(initial_state)
report = analyze_run(builder, adapter=builder) # 2) 该运行的观察到的依赖图
print(report.keystone) # 运行所依赖的步骤
```
```bash
pip install "auditable[langgraph]"
python examples/example_langgraph_capture.py # 真实的 LangGraph 运行 -> 100% 观察到,关键节点命名
```
同一个封装的构建器还会产生 **可重放** 记录,因此 LIVE 支柱在捕获的运行上运行,而不是手动构建的字典。`builder.to_records(decisions={"approve": "vendor_payment"})` 将一个标记的决策节点降低到一个 `DecisionRecord`,携带它所依赖的状态,而 `replay(record, live_state=...)` 在实时状态下重新决策它,并路由回滚。参见 [`example_langgraph_live_replay.py`](examples/example_langgraph_live_replay.py):一个真实的 LangGraph 运行,捕获、排名(POST),然后在预算偏移下重放和逆转(LIVE)。
想要一个真实的模型在循环中吗? [`example_langgraph_llm_agent.py`](examples/example_langgraph_llm_agent.py) 使用与任何 OpenAI 兼容的端点(一个普通的 OpenAI 密钥,一个网关或一个本地 vLLM 或 Ollama 服务器)运行相同的捕获,捕获的边是相同的,因为捕获看到节点读取和写入的状态通道,而不是内部的模型调用。
不是 LangGraph?一个单行回调函数捕获任何 LangChain 可运行的函数(`auditable.integrations.langchain`),一个就地 `instrument` 记录 MCP 服务器边界上的每个工具调用(`auditable.integrations.mcp`),而与框架无关的 `TouchRecorder` 通过声明每个步骤的 `reads()` 和 `writes()` 从任何循环(原始 OpenAI 或 Anthropic 智能体,您自己的调度器)捕获相同的观察边。参见 [`examples/example_touch_capture.py`](examples/example_touch_capture.py)。 **路线图:** CrewAI 和 OpenTelemetry。
## 示例和集成
将 `可审计` 指向一个场景,它会构建相同的类型图。每一行都链接一个可运行的示例;在 [`examples/README.md`](examples/README.md) 中浏览它们。
| 场景 | 支柱 | 从... 构建图 | 运行 |
|---|---|---|---|
| 捕获真实的 LangGraph 智能体 | LIVE → POST | 一个实时 `StateGraph` 运行(`instrument`) | [`example_langgraph_capture.py`](examples/example_langgraph_capture.py) |
| 捕获真实的 LLM 智能体(实时模型) | LIVE → POST | 一个模型驱动的 `StateGraph` 运行(`instrument` + OpenAI 兼容) | [`example_langgraph_llm_agent.py`](examples/example_langgraph_llm_agent.py) |
| 捕获真实的 LangChain 可运行函数 | LIVE → POST | 任何可运行函数的回调函数(`LangChainCallbackHandler`) | [`example_langchain_capture.py`](examples/example_langchain_capture.py) |
| 捕获任意工具循环 | LIVE → POST | 声明的资源触摸(`TouchRecorder`) | [`example_touch_capture.py`](examples/example_touch_capture.py) |
| 捕获 MCP 工具流量在服务器边界 | LIVE → POST | 仪器化的 FastMCP 服务器(`instrument`) | [`example_mcp_capture.py`](examples/example_mcp_capture.py) |
| 捕获 LangGraph 智能体,然后重放和逆转它 | LIVE → POST | 一个实时 `StateGraph` 运行降低到可重放记录(`instrument` + `to_records`) | [`example_langgraph_live_replay.py`](examples/example_langgraph_live_replay.py) |
| 在部署前检查声明的计划 | PRE | 一个与框架无关的计划字典(`declared_plan_v1`) | [`example_pre_lint_plan.py`](examples/example_pre_lint_plan.py) |
| 在预算偏移时恢复支付 | LIVE | 实时捕获的决策(`audit` + `replay`) | [`example_live_replay.py`](examples/example_live_replay.py) |
| 在运行过程中监控,实时命名关键节点 | LIVE | 运行的分数前缀(`LiveSession`) | [`example_live_monitor.py`](examples/example_live_monitor.py) |
| 对 tau-bench 运行进行排名,命名关键节点 | POST | tau-bench 轨迹(`tau_bench_prior_db_reads_v1`) | [`example_post_rank_run.py`](examples/example_post_rank_run.py) |
| 运行一个支付流程,经历每个支柱 | PRE, LIVE, POST | 整个生命周期(`own_record_v1` 用于 POST) | [`example_end_to_end.py`](examples/example_end_to_end.py) |
前六行捕获真实的运行;参见 [接入您的智能体](#接入您的智能体) 获取两行设置。 **路线图:** CrewAI 和 OpenTelemetry。
## 生命周期
`可审计` 在智能体的生命周期中的三个时间点对同一个类型决策图运行相同的检测和报告过程。图内核保持不变;只有支柱发生变化(何时触发,评估什么)。
| 支柱 | 何时触发 | 公共入口 | 关注点 |
|---|---|---|---|
| **PRE** | 部署前 | `analyze_plan` | 对声明的计划进行只读结构检查。命名控制流阻塞点。依赖状态风险保留。 |
| **LIVE** | 运行中 | `audit` + `replay` + `ActionGate` | 捕获决策,在实时状态下重新决策,通过轨道路由修复(允许,阻止,审查,回调)。最尖锐的支柱。 |
| **POST** | 运行后 | `analyze_run` | 按结构爆炸份额对完成运行进行排名。命名运行所依赖的关键节点,以便您首先审查该步骤。 |
## 安装
```bash
pip install auditable
```
核心无依赖,torch-free。结构图分析(`analyze_plan` 用于 PRE,`analyze_run` 用于 POST)需要可选图额外(NetworkX):
```bash
pip install "auditable[graph]"
pip install "auditable[anomaly]"
```
图额外添加 NetworkX。异常额外添加拟合的 `DataAuditor` 路径,通过 PyOD;保鲜度后备和 LIVE 示例在核心安装上运行。
文档:https://auditable-ai.readthedocs.io/
## 三大支柱,详情
<details>
<summary><b>PRE:在部署前检查计划</b>(四个只读检查,瓶颈,一个覆盖率报告)</summary>
`analyze_plan` 函数指向一个已声明的计划(一个普通的字典,一个中立的目标,由 LangGraph、CrewAI 或 AutoGen 前端降低为),并对计划图运行只读结构检查。每个检查都是一个纯粹的 NetworkX 查询:不会执行任何值,每个发现都是一个结构设计警告,而不是一个验证失败预测。
```python
from auditable.graph.pre import analyze_plan
from auditable.graph.adapters import declared_plan_v1
plan = {
"nodes": [
# 0: 读取一个易变的價格,但授予的范围远远超过它读取的范围。
{"idx": 0, "agent": "planner", "kind": "tool_calls",
"reads": [{"id": "price", "volatile": True}],
"scope": ["price", "ledger", "vendor_db"]},
# 1: 一个依赖于未固定的、未经重新验证的价格的决策。
{"idx": 1, "agent": "planner", "kind": "decision",
"reads": [{"id": "price", "producer": 0, "volatile": True}],
"control_preds": [0]},
# 2: 一个 consequential 的 'order' 写操作,没有之前的 'order' 读取,也没有在易变的读取和动作之间重新读取 'price'。
{"idx": 2, "agent": "executor", "kind": "tool_calls",
"reads": [{"id": "price", "producer": 0, "volatile": True}],
"writes": ["order"], "control_preds": [1]},
]
}
report = analyze_plan(plan, adapter=declared_plan_v1)
print(report)
```
四个发布的检查,都是只读查询,严重程度为 `warning`:
| 检查 | 触发条件 |
|---|---|
| `write_with_no_prior_read` | 节点写入一个资源,但其反向切片中没有任何内容读取过该资源。 |
| `flippable_dependency_annotation` | 一个未固定的、未经重新验证的易变依赖关系影响决策。这是注释;是否会翻转的问题需要运行时值,不在此范围内。 |
| `scope_vs_snapshot` | 授予的工具范围严格超过节点读取的快照。 |
| `missing_revalidation_barrier` | 易变读取到达一个结果动作,但没有中间重新读取。漂移确认需要运行时值,不在此范围内。 |
报告还命名了**执行拓扑关键节点**:声明计划的结构瓶颈,即大多数其他节点在控制流中 transitively 遵循的节点(`execution_reach` 在 `handoff_to` 投影上的 argmax)。这是结构设计检查,与 POST 辐射半径关键节点是不同的概念,它不预测失败。
除了检查外,**预飞行覆盖率报告** 是一种描述性覆盖率准备情况视图,明确不是风险评分。它报告依赖边等级混合、观察到的分数、饱和度比率、运行时评分器将应用的确切无分数原因、哪些声明的读取、写入和边仍然缺乏资源标识,以及每个资源声明的重新验证屏障。
两个界限,明确说明。依赖状态爆炸共享风险在 PRE 处**保留**:声明的依赖层仅为声明(观察到的分数为零),因此 `analyze_plan` 返回 `state_b_risk=None` 且 `state_b_withheld=True` 和一个原因字符串,如果有评分判决返回,它会引发而不是发出数字。表格风险 OWASP-Agentic 和 CWE 规则地板**计划**,但未发布。
参见 [`examples/example_pre_lint_plan.py`](examples/example_pre_lint_plan.py) 和 [PRE 规则参考](docs/pre-rules.md)。
</details>
<details>
<summary><b>POST:评估已完成的运行,找到关键节点</b>(`analyze_run` 在记录的轨迹上)</summary>
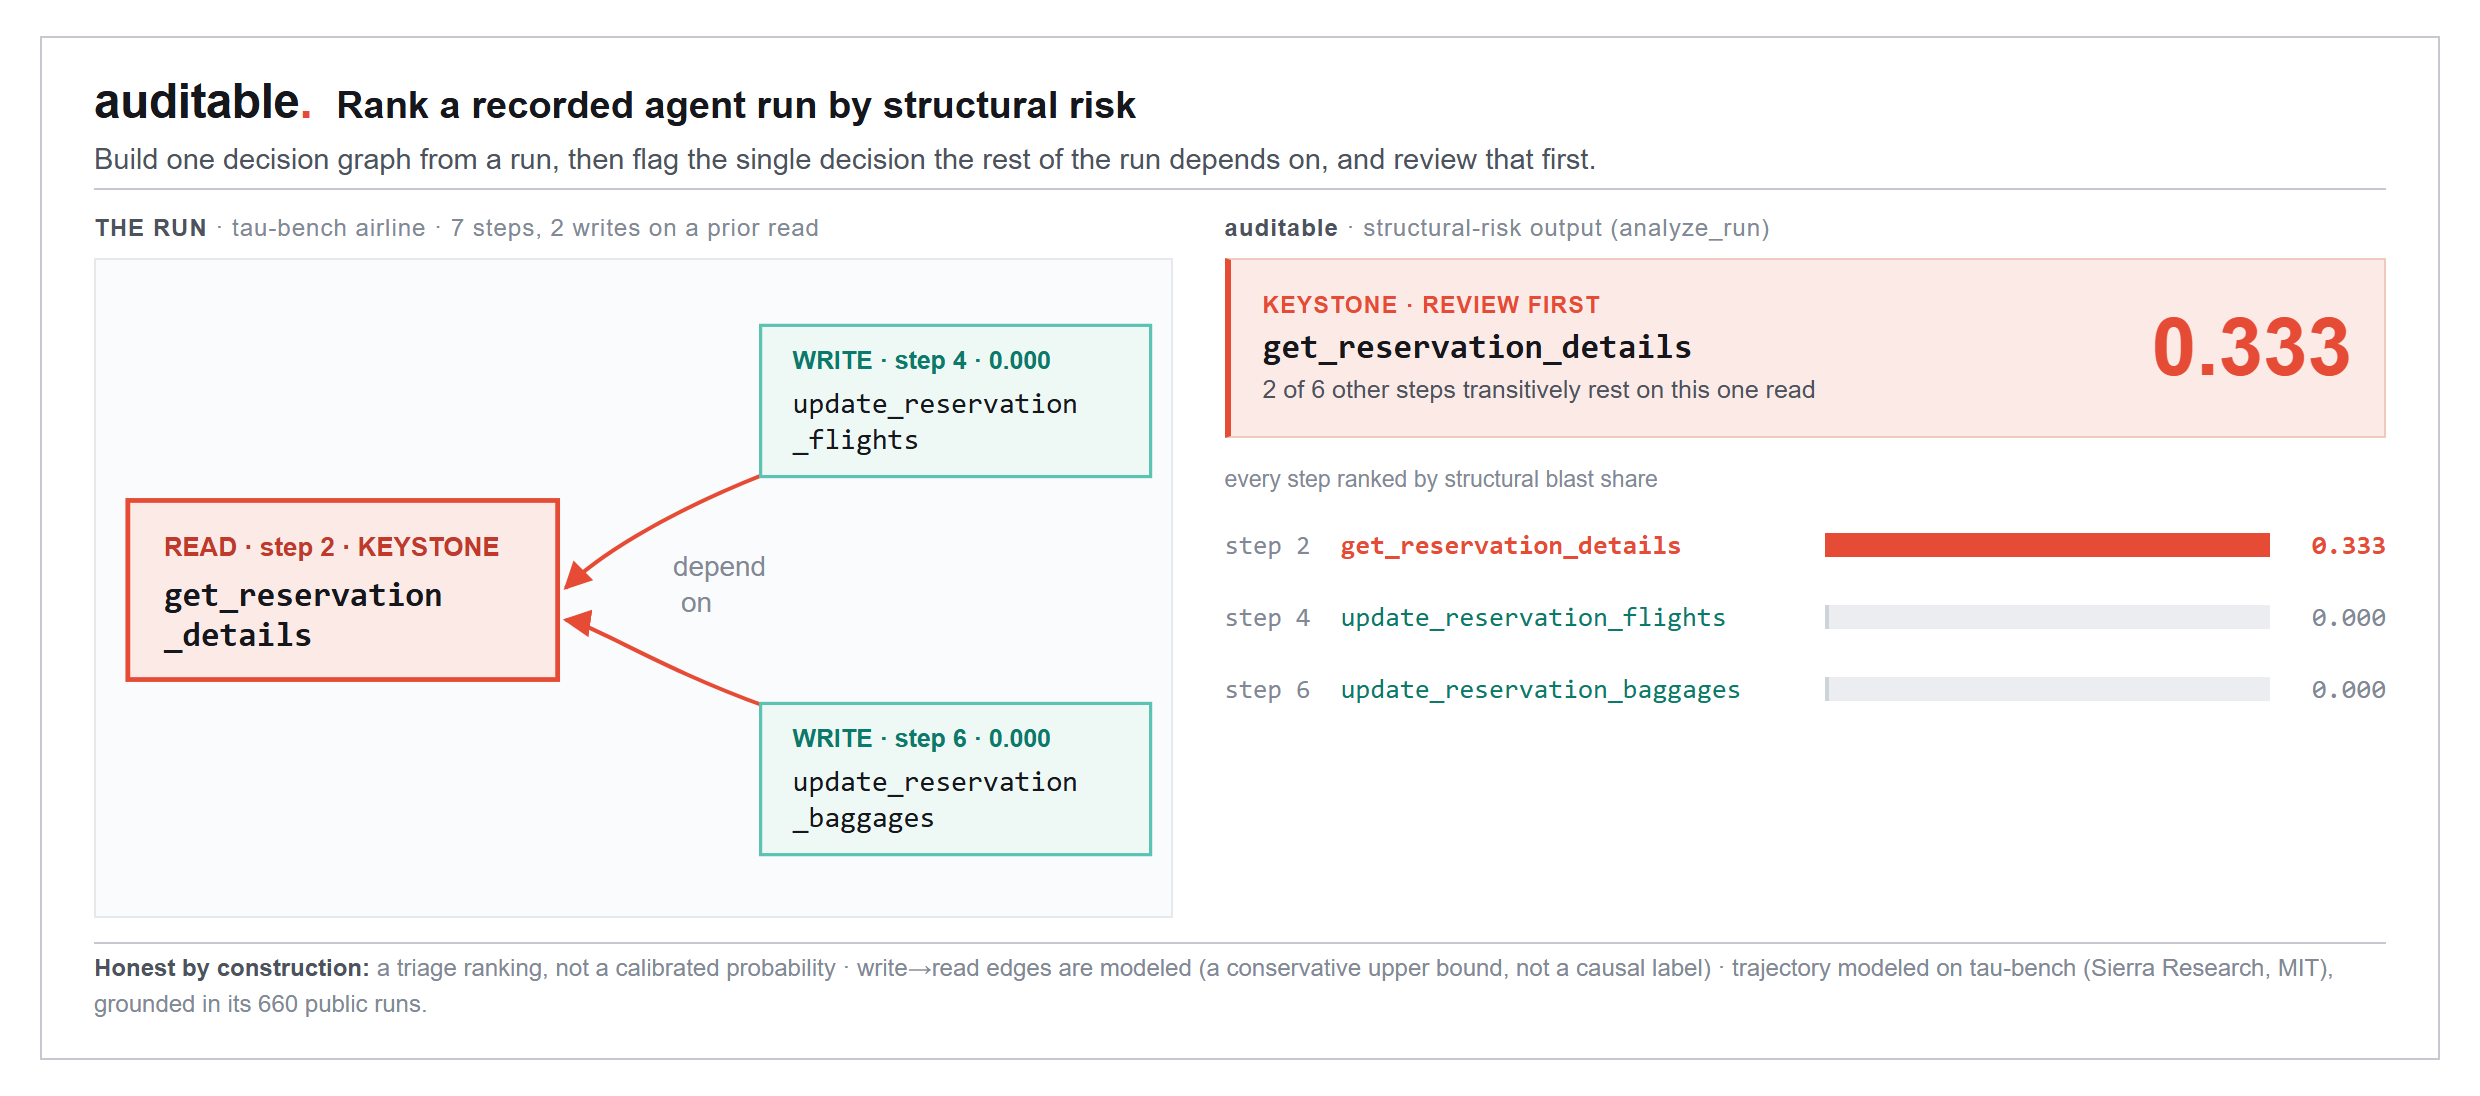
`analyze_run` 读取记录的代理运行,构建一个决策图,并根据运行的 transitively 依赖关系对每一步进行排名,以便您首先查看关键节点。在 tau-bench 航空公司轨迹上,两个后续写入依赖的预订读取是关键节点。
```python
from auditable import analyze_run
from auditable.graph.adapters import tau_bench_prior_db_reads_v1
report = analyze_run(run, adapter=tau_bench_prior_db_reads_v1)
k = report.keystone
print(k.idx, k.node_attrs["tool"]) # 2 get_reservation_details
```
评分是一种未校准的分诊排名,而不是校准的概率。在无评分状态(`no_score:single_decision`,`no_score:low_coverage`)下,分数为 `None`,因此保留的分数永远不会被读取为零风险。语料库写入-读取边被建模(保守的先验读取上限,而不是因果标签);报告在 `report.notes` 中包含这些警告。该轨迹建模于 [tau-bench](https://github.com/sierra-research/tau-bench) (Sierra Research,MIT)。参见 [`examples/example_post_rank_run.py`](examples/example_post_rank_run.py) 和 [POST 分析参考](docs/post-analysis.md)。
</details>
<details>
<summary><b>工作原理:两层图,签名记录,钢轨</b>(内核内部)</summary>
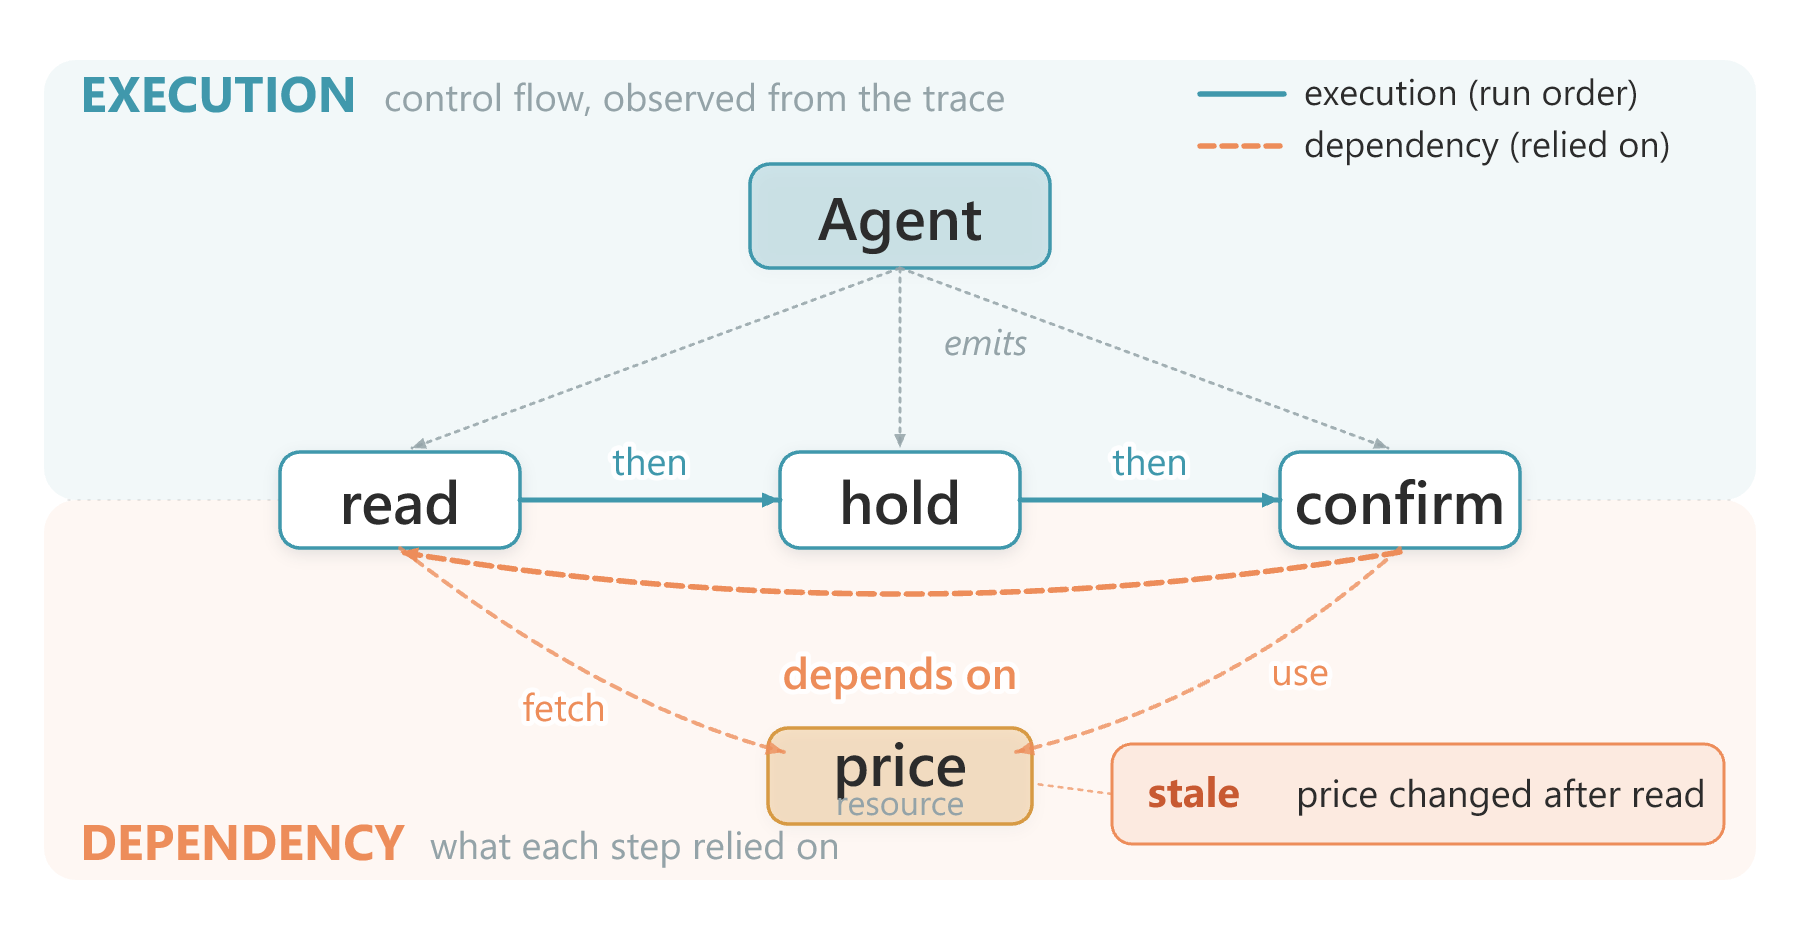
*auditable 将运行链接到一个具有两个边层的图中:执行(控制流,从跟踪中观察)依赖(依赖关系,每个步骤依赖于什么)。当步骤依赖于一个值时,该值自此已过时,例如 `price`,`replay` 会捕获它。记录本身绑定三个范围(数据,模型,执行环境)。*
图内核具有两个边层,区分是负载的。执行边(`emits`,`handoff_to`)从跟踪中观察。依赖边(`depends_on`)是声明的、推断的或观察到的,每个边记录它是如何知道的:语料库和计划适配器声明或推断它们,而 LangGraph 捕获路径和 `TouchRecorder` 从实际运行中读取它们为观察到的通道触摸。PRE 和 POST 都运行在此相同的类型图上;`audit()` 是便捷的捕获入口,因此您永远不需要手动构建图。
一个代理决策跨越三个范围,`auditable` 将所有三个绑定在一个签名、哈希链接的记录中:
| 范围 | 记录绑定内容 | v0.1 中的信号 |
|---|---|---|
| **数据** | 代理读取的内容和依赖快照 | 快照新鲜度 |
| **模型** | 哪个模型产生输出及其声明基础 | 决策基础信任标志 |
| **执行环境** | 执行的动作及其成本 | 静态成本上限规则,加上重放判决 |
`replay()` 重新推导出动作在实时依赖状态下是否仍然成立,与代理使用的快照相比,并返回四个路由判决之一:`ALLOW`,`ROLLBACK`(在快照上证明,但在实时状态下不成立,过时状态情况),`BLOCK`(在两者上都不成立),或 `HUMAN_REVIEW`(策略引发 `ReplayUndecidable`)。`Policy` 是任何可调用 `(state, action) -> (justified, reason)`。然后 `ActionGate` 通过 `Rail` 执行该判决:后提交 `ROLLBACK` 或 `BLOCK` 调用 `rail.compensate(receipt)` 以反转提交的动作,而不是打印建议。发布的 `ReferenceLedger` 是一个进程内的参考钢轨,用于演示和测试;它不是生产付款钢轨。
记录签名并哈希链接:每个记录都包含一个 `prev_digest` 和一个内容寻址的 `record_id`。今天有两个接收器,`MemorySink`(进程内)和 `FileSink`(仅追加的 JSONL,跨进程退出持久,失败关闭时尾部损坏)。
通过公共 `Adapter` 协议,摄入是源无关的。语料库和计划适配器发布 `tau_bench_prior_db_reads_v1`(公共语料库轨迹,POST),`own_record_v1`(auditable 的签名记录,POST)和 `declared_plan_v1`(与框架无关的声明计划字典,PRE)。对于实际运行,LangGraph 捕获路径(`auditable.integrations.langgraph.instrument`)和通用 `TouchRecorder` 使用结构化的 `ResourceRef` 生成观察到的依赖边,与 superstep-aware 和 reducer-aware 相匹配。声明计划适配器停留在中立的 PRE 接缝处,LangGraph 或 CrewAI 前端将计划降低为;它不是任何框架的解析器。
参见 [架构参考](docs/architecture.md) 以获取完整的内核、适配器和接收器。
</details>
<details>
<summary><b>使用单层</b>(独立审计器作为记录的输入)</summary>
每个范围的检查都是一个独立的 `Auditor`,它独立运行,没有代理和链条,并返回一个签名的 `Report`。`DataAuditor` 评估快照新鲜度,`ModelAuditor` 生成决策基础信任标志,`HarnessAuditor` 应用静态成本上限规则。
```python
import time
from auditable import DataAuditor, DependencySnapshot
snapshot = DependencySnapshot(state={"budget_remaining": 1000}, captured_at=time.time() - 7 * 86400)
report = DataAuditor(max_age_seconds=86400).assess(snapshot)
print(report.flag, report.score) # stale 1.0
```
这些独立审计器是记录的输入,而不是主要的。合成(捕获、重放、恢复和生命周期支柱)是主线;模块为其提供支持。参见 [`examples/example_standalone_report.py`](examples/example_standalone_report.py)。
</details>
<details>
<summary><b>范围,诚实说明</b>(今天发布的内容 vs. 计划中的内容)</summary>
**今天发布的内容**。完整的签名链,重放实时状态,通过钢轨中立门户执行恢复,两个接收器(内存和追加 JSONL),POST `analyze_run` 排名,PRE `analyze_plan` 检查和预飞行覆盖率报告,实际运行捕获到观察到的依赖边(LangGraph 通过 `instrument`,任何循环通过 `TouchRecorder`)。
拟合的数据异常路径作为一个未提升的模块 API 发布,`LiveSession` 前缀评分也发布。该版本**不**声称基准级检测证据、校准模型信任评分或校准跨层风险。POST 结构评分是一个未校准的排名;复合报告是一个透明的、明确未校准的调试包。校准复合评分仍在 [路线图](#roadmap) 中。
</details>
## 路线图
<details>
<summary>今天发布的内容和下一步计划</summary>
<br>
今天发布:完整的捕获、重放和恢复链;PRE 计划检查;POST 运行排名;`LiveSession` 前缀评分;签名、哈希链接的记录;两个接收器。拟合的 PyOD 检测器依赖快照也发布为一个未提升的模块 API, freshness 作为后备;提升等待基准级证据。接下来:
- **一个校准的复合评分。** 将数据、模型和动作信号组合成一个单独的校准评分,将模型视为图中的一等节点。
- **自动修复。** 刷新过时数据,隔离不良输入,退回到更安全的模型,或需要人工签名。
- **内置 CI 检查。** 一个表格风险 OWASP-Agentic 和 CWE 规则地板,用于持续集成。
- **集成(1.0)。** LangGraph 捕获 (`instrument`),LangChain 回调和 MCP 工具边界捕获今天发布;接下来是 CrewAI 钩子,导出到 OpenTelemetry 和 LangSmith,可下载的证据包和稳定的公共 API。
</details>
## 相关项目
`auditable` 是小型开放代理可靠性项目的一部分:
- **[awesome-auditable-ai](https://github.com/yzhao062/awesome-auditable-ai)** — 人工智能代理可靠性和审计的精选阅读清单。
- **[GRADE](https://arxiv.org/abs/2606.22741)** — 支持此库的 typed 两层图的研究(也可在 [参考文献](#references) 中找到)。
## 参考文献
<details>
<summary>比较工具、基准和评估方法</summary>
<br>
上述表格中的功能标记均根据 2026 年的公开文档为准。
**比较工具**
<a id="ref-1"></a>`[1]` [LangSmith](https://docs.langchain.com/langsmith)<br>
<a id="ref-2"></a>`[2]` [Langfuse](https://github.com/langfuse/langfuse)<br>
<a id="ref-3"></a>`[3]` [Arize Phoenix](https://github.com/Arize-ai/phoenix)<br>
<a id="ref-4"></a>`[4]` [Weights & Biases Weave](https://github.com/wandb/weave)<br>
<a id="ref-5"></a>`[5]` [DeepEval](https://github.com/confident-ai/deepeval)<br>
<a id="ref-6"></a>`[6]` [Ragas](https://github.com/explodinggradients/ragas)<br>
<a id="ref-7"></a>`[7]` [promptfoo](https://github.com/promptfoo/promptfoo)<br>
<a id="ref-8"></a>`[8]` [OpenAI Evals](https://github.com/openai/evals)<br>
<a id="ref-9"></a>`[9]` [NeMo Guardrails](https://github.com/NVIDIA-NeMo/Guardrails)<br>
<a id="ref-10"></a>`[10]` [Guardrails AI](https://github.com/guardrails-ai/guardrails)<br>
<a id="ref-11"></a>`[11]` [Lakera Guard](https://www.lakera.ai/lakera-guard)
**基准和数据集**
<a id="ref-12"></a>`[12]` [tau-bench](https://github.com/sierra-research/tau-bench) (arXiv:2406.12045)<br>
<a id="ref-13"></a>`[13]` [Who&When: Which Agent Causes Task Failures and When?](https://github.com/ag2ai/Agents_Failure_Attribution) (arXiv:2505.00212)
**方法**
<a id="ref-14"></a>`[14]` [GRADE: 图表示 LLM 代理依赖和执行](https://arxiv.org/abs/2606.22741)
</details>
## 引用
如果您在工作中使用 `auditable`,请引用 GRADE 论文,即支持该库的 typed 两层图模型:
```bibtex
@article{zhao2026grade,
title = {GRADE: 图表示 LLM 代理依赖和执行},
author = {Zhao, Yue},
journal = {arXiv preprint arXiv:2606.22741},
year = {2026}
}
```
## 许可证
[Apache-2.0](LICENSE)。
连接信息
猜你喜欢
暂无推荐服务器