

内容
# gate.cat
> **安装:** 运行用户本地安装程序以下内容 — 它创建了一个私有的虚拟环境,同样适用于PEP 668系统:
> ```bash
> curl -fsSL https://raw.githubusercontent.com/BGMLAI/gate.cat/master/install.sh -o /tmp/gatecat-install.sh
> sh /tmp/gatecat-install.sh
> ```
> 或者使用手动虚拟环境路径:`python3 -m venv .venv && .venv/bin/python -m pip install gate.cat`。
> ```python
> from gatecat import check_action # 拒绝名单网关
> check_action("agent", "terraform destroy -auto-approve") # -> 引发 ActionVetoed
> ```
> 发行版为 `gate.cat` (PyPI也接受规范拼写 `gate-cat`);
> 导入模块为 `gatecat`。0.2.x 使用 `import cacheback` — 参见 `MIGRATION.md`。
> 开诚布公:网关仅对它**阻止**的内容有把握。
> 它不匹配的动作是*未检查*,而不是*安全*。
**阻止您的AI代理在采取不可逆转的行动之前。** 动作否决是
**确定性和模型无关性** — 一个拒绝名单 + 执行检查 + 人在环中,
在边界处检查*工具调用*,因此它以相同的方式保护任何代理:
一个Claude Code钩子(前沿),一个crewAI/LangGraph应用程序,
或Ollama/vLLM上的本地7-30B模型。`TruthPipeline`
添加一个诚实的判决(确认/驳斥/不确定/未检查)使用确定性检查
(执行/计算/查找)加上样本传播不确定性信号;`veto.py`消费该判决以
阻止,暂停或要求人类在工具调用执行之前。 (该不确定性*信号* - 一个
次要功能 - 是7-30B本地模型强度的所在地;参见下面的“为什么小型/廉价模型”。
否决本身不需要这样的假设。)
一个机制,而不是两个产品:验证引擎(`TruthPipeline`)和消费它的动作网关
(`before_action` / `VetoGate`)一起发布 - 相同的软件包,相同的品牌。
语义缓存和缓存增强合成(如下)是两者下面的支持引擎。
[](https://github.com/BGMLAI/gate.cat/actions/workflows/ci.yml)
[](https://pypi.org/project/gate.cat/)
[](LICENSE)
[](https://pypi.org/project/gate.cat/)
[](https://gate.cat)
**实际拦截,每月:** [gate.cat](https://gate.cat) 发布*否决拦截* -
一个代理试图的实际不可逆命令,以及墙壁如何阻止它。
一个AI代理决定运行README的安装一行程序。 网关在
单个字节执行之前阻止它 - 一个真正的终端,`pip install gate-cat`,
没有蒙太奇:
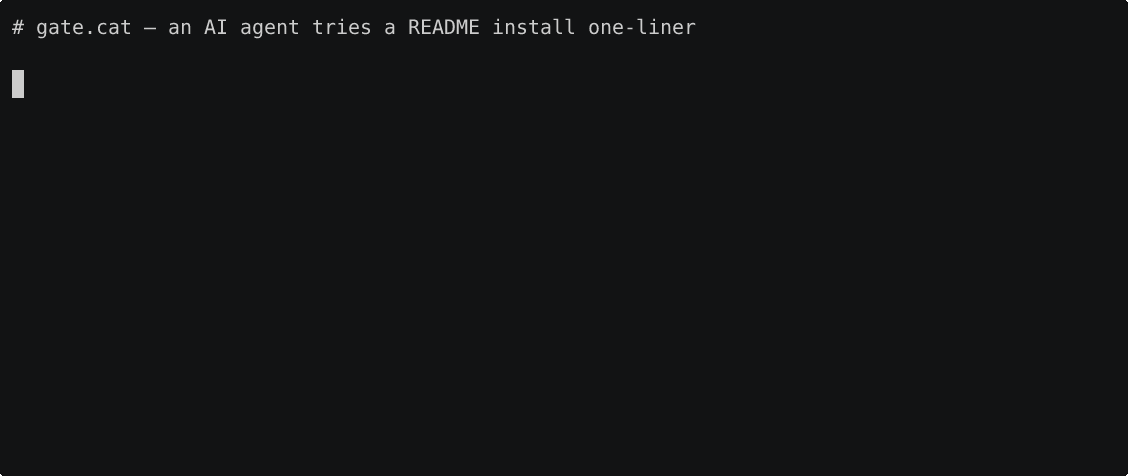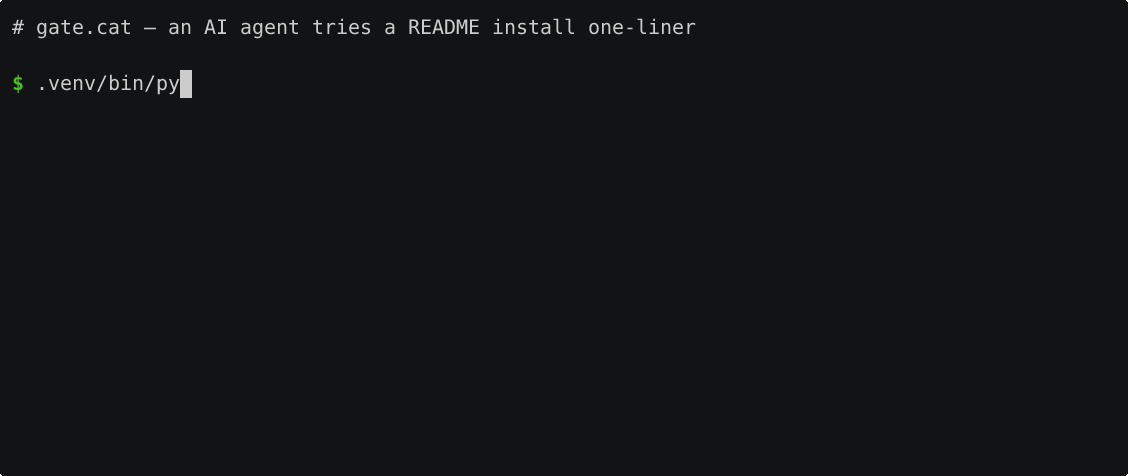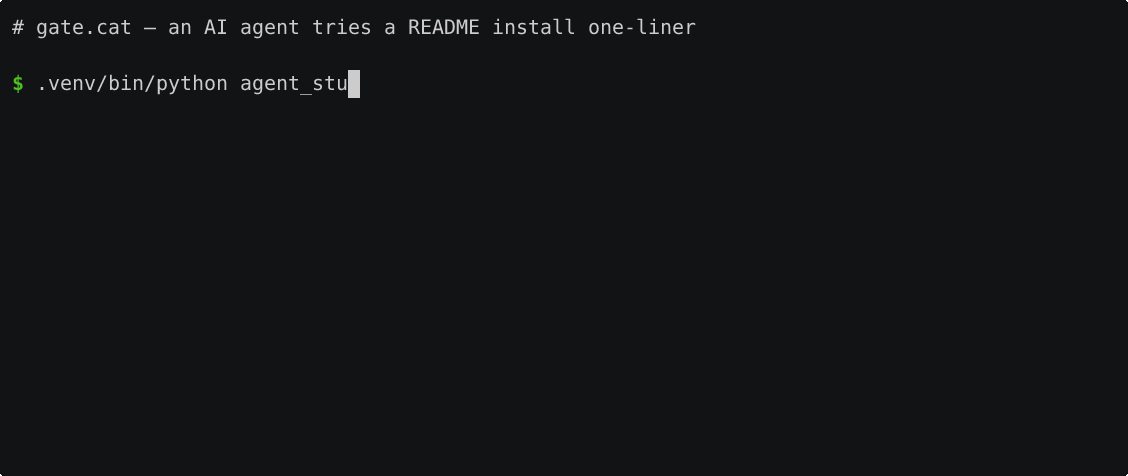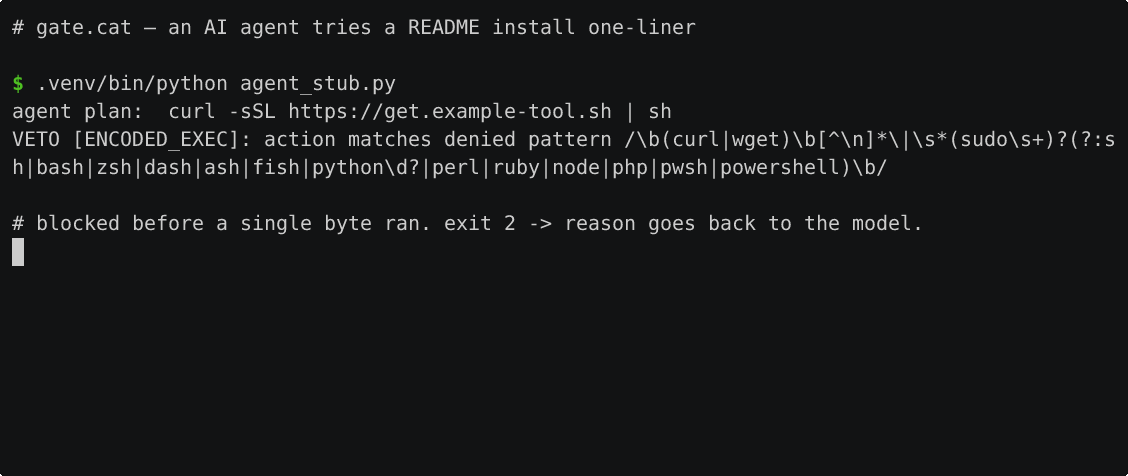
<sub>阻止`curl … | sh`模式,特别是;混淆/ base64安装技巧仍然逃避 - 参见[OBJECTIONS.md](OBJECTIONS.md)。演员:[`docs/demos/demo_a.cast`](docs/demos/demo_a.cast).</sub>
## 安装
```bash
pip install gate.cat # 核心(在虚拟环境中)
pip install "gate-cat[openai]" # + OpenAI包装器
pip install "gate-cat[anthropic]" # + Anthropic包装器
pip install "gate-cat[proxy]" # + 代理服务器(FastAPI)
pip install "gate-cat[all]" # 所有功能
```
> 引号包装额外功能(`"gate-cat[openai]"`)- zsh将裸`[...]`视为全局匹配。
**永久免费** - 完整的本地网关, 无速率限制。 付费层是可选的,默认关闭:
**Cloud Solo €19/mo · Team €149/mo flat(最多10台机器)· Business €399/mo · 一次性 €29 政策包** - 详情和诚实的边界在[PRICING.md](PRICING.md)。 阻止从不依赖于付款。
## 钩子 - 最强模式
在执行环境中执行**,**在模型的控制流程之外**:工具调用
在网关返回之前无法执行。 `pip install gate-cat` 将
`gatecat-hook`控制台脚本放在您的PATH上;通过添加以下内容到`.claude/settings.json`注册为Claude Code的`PreToolUse`钩子(无需编辑 -
它按名称调用,无需绝对路径):
```json
{
"hooks": {
"PreToolUse": [
{
"matcher": "Bash|Write|Edit",
"hooks": [{ "type": "command", "command": "gatecat-hook" }]
}
]
}
}
```
现在要求您的代理运行`rm -rf ~/project`:调用被阻止(退出2)并且
模型看到`VETO [DELETE_ANALYZER]:删除'/home/you/project'在受保护的根'/home'下 - 需要人类`。
在像`/tmp/x`这样的临时路径下的删除**被允许** - 网关阻止触及持久位置的删除,并且不会在临时目录中唠叨。 运行`gate.cat`随时查看它监视和阻止的内容。 失败关闭:缺少或出错的引擎
阻止而不是允许。 在临时CI/沙盒中,它会自行解除并记录一个无操作(`GATECAT_VETO_EPHEMERAL=0`强制启用)。
还存在框架适配器(crewAI / LangGraph / AutoGen),但它们是进程内约定 -
提示注入可以绕过它们。 只有钩子是代理无法跳过的执行。
参见[`examples/veto_integrations/`](examples/veto_integrations/)以获取适配器用法。
## 被管制的shell - 适用于任何shell出命令的代理
不在Claude Code上? 钩子仅在那里触发,而代理只看到OpenAI-API模型层发出的数据。
但是**几乎每个代理最终都会通过shell运行命令** - `sh -c "<command>"`。
`gatecat-shell`位于该执行点:指向代理的shell并检查每个命令,
与钩子使用相同的确定性引擎,然后再运行真正的shell。
```bash
# 管制一个命令,然后运行它 - 阻止 => 退出2,真正的shell永远不会看到它
gatecat-shell -c "rm -rf ~/project" # VETO [DELETE_ANALYZER] ... 退出2
gatecat-shell -c "git status" # 允许 -> 执行 /bin/sh -c "git status"
# 仅管制,不执行(用于git钩子,CI包装器,其他代理的基元)
gatecat-shell --check "terraform destroy -auto-approve" # 退出2
echo "DROP TABLE users" | gatecat-shell --check # 退出2
# 对于任何驱动bash会话的代理,您可以启动:DEBUG陷阱网关
eval "$(gatecat-shell --install-bash)"
```
将代理的执行指向它,无论工具允许您设置shell命令的位置(许多工具遵循`$SHELL`或配置执行设置)。
真正的shell是`/bin/sh`;设置`GATECAT_SHELL_REAL=/bin/bash`以更改它。
受控命令按字节传递 - 网关看到了它运行的确切字符串,因此
没有重新解析间隙。
**诚实标记,诚实标注.** 将其设置为代理的*shell二进制*(`-c`模式),
这是执行环境以外的控制 - 相同的类别作为钩子。
`--install-bash`DEBUG陷阱较弱:
会话内的命令可以`trap - DEBUG`禁用它,因此请优先在您可以的位置设置shell二进制。
无论哪种方式,它都是**字符串网关,不是沙盒** - 它读取命令,
不包含进程;将代理运行在OS沙盒**和**网关前面。 失败关闭:
引擎故障,不可解析的`-c`或评估错误以退出2而不是运行命令。
## 停滞 - 捕捉一个忙碌但停滞的代理
拒绝名单阻止一个危险命令;它对*安全*命令不发出任何信息,这些命令永远不会取得进展 -
代理重新运行一个失败的构建,或重新提出相同的错误修复。
`StateStagnationDetector`监视代理的**状态**跨步骤,并在状态停止移动时停止它:
```python
from gatecat.state_stagnation import StateStagnationDetector
det = StateStagnationDetector(max_repeat_action=2, max_no_change=2)
for step in agent_loop():
reason = det.update(action=step.tool_calls, state_repr=step.diff,
error=step.error, cost=step.cost, progress=step.tests_passing)
if reason:
pause_and_report(reason); break # 环路没有移动 - 回滚 / 升级
```
`update()`返回第一个触发信号的原因(`repeat_action`,
`no_state_change`,`repeat_error`,`cost_without_progress`)或`None`。
它是**确定性**的 - 重点是编码错误通常是*自信错误*:
模型以零散度重新提出相同的错误修复,因此概率分歧门对它视而不见,
而状态比较无论置信度如何都捕捉循环。
## Truth Pipeline(koryto → gate → 否决)
一个入口点,将SDK的验证块组合成一个真理 + 合规管道,适用于任何模型
(3B SLM在手机上和前沿LLM使用相同的`sample_fn`回调)。
```python
from gatecat import TruthPipeline, ActionPolicy, ActionVetoed
pipe = TruthPipeline(
sample_fn=my_llm, # 回调(prompt) -> str
fact_base={"capital of france": "Paris"}, # 查询通道(可选)
policy=ActionPolicy(deny=[r"terraform.*prod"], max_amount=100.0),
)
r = pipe.evaluate("Evaluate: 6 / 2 * 3", answer="1")
r.verdict # "refuted" - 确信错误,确定性,$0
r.truth # "9" - 正确的值,以便调用者可以自我纠正
@pipe.guard() # 动作合规
def deploy(target): ...
deploy(target="terraform apply prod") # 在执行前引发ActionVetoed
pipe.compliance_report() # 审计跟踪:判决 + 否决
```
一个策略在行动:`dev`运行,`destroy prod`被拒绝,`apply staging`升级到人类 -
一个确定性的门,三个结果:
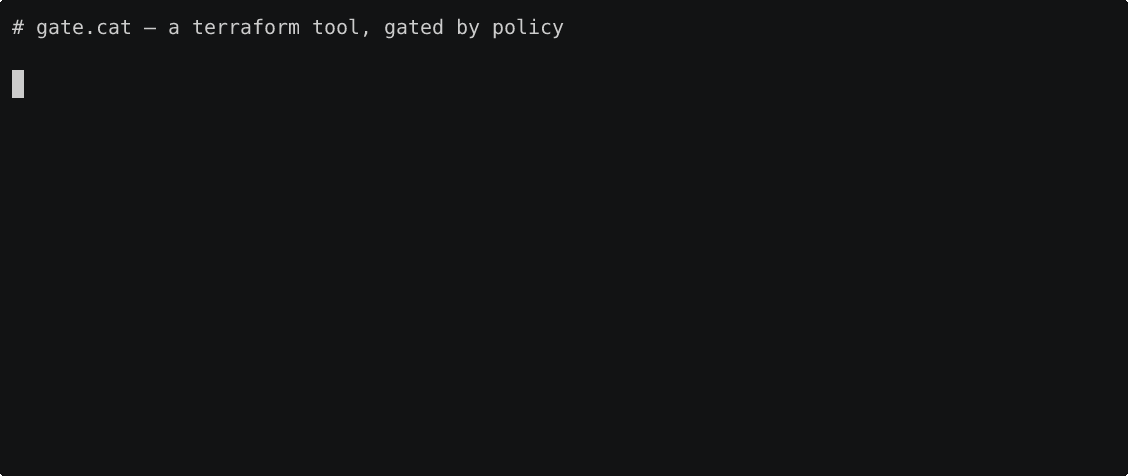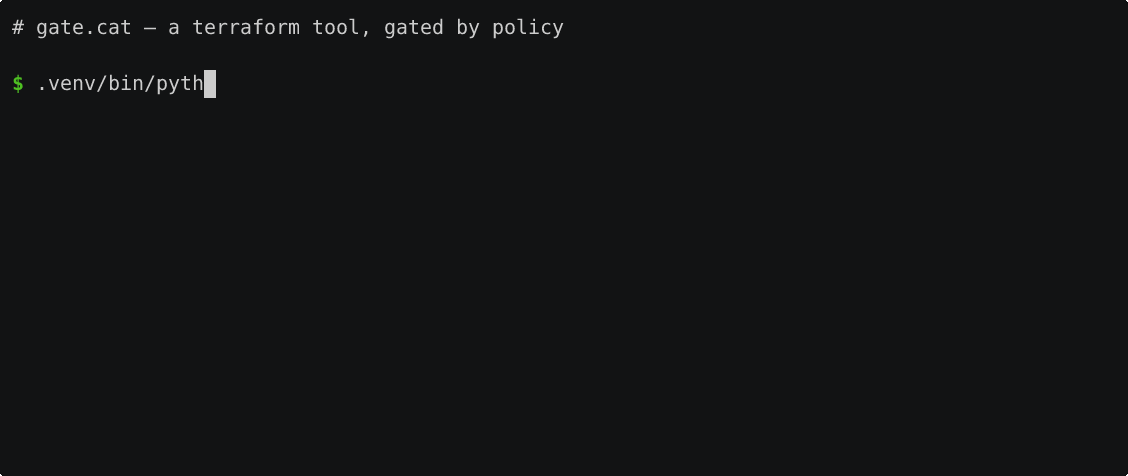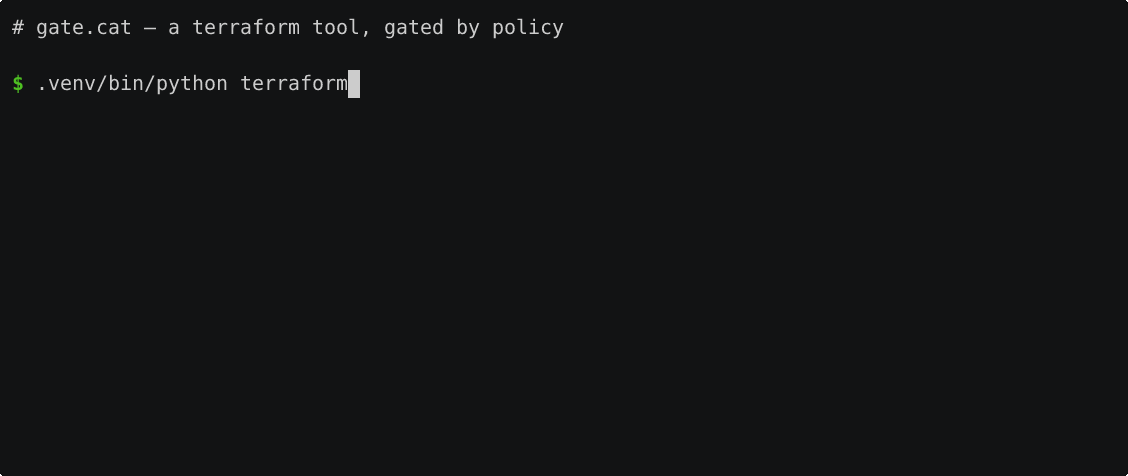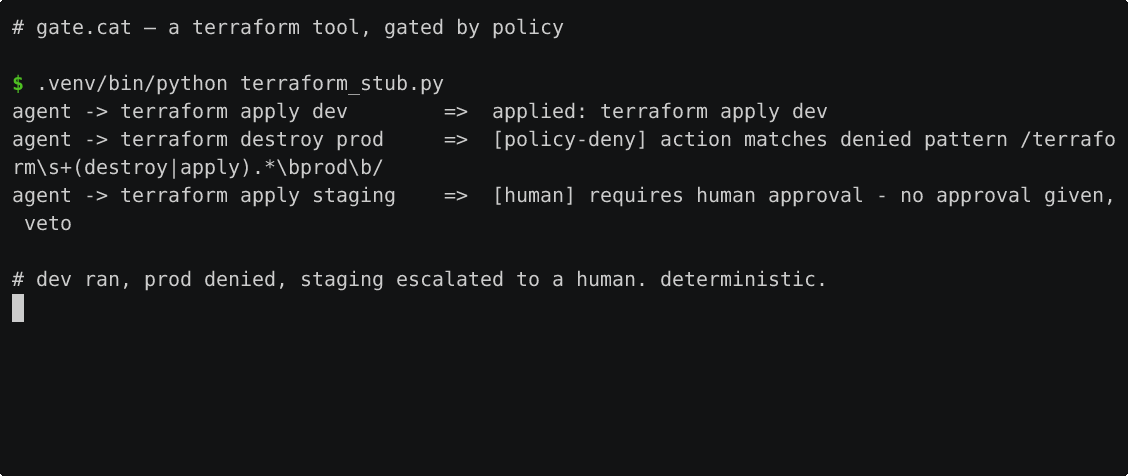
<sub>来源:[`examples/veto_terraform.py`](examples/veto_terraform.py)。演员:[`docs/demos/demo_b.cast`](docs/demos/demo_b.cast).</sub>
**诚实的判决** - 管道永远不会声称比它测量的更多:
| 判决 | 含义 | `reliable` | `trusted` |
|---|---|---|---|
| `confirmed` | 答案与验证的原子匹配 | ✅ | ✅ |
| `refuted` | 答案与验证的原子相矛盾 | ❌ | ❌ |
| `uncertain` | 软分歧,无仲裁者,或样本传播高 | ❌ | ❌ |
| `unchecked` | 在验证范围内 - **不是**“真实”,只是“无法检查” | ❌ | ✅ |
对于关键系统,请过滤`report.reliable`(仅确认),而不是`trusted`。
> **网关捕捉**犹豫**,不捕捉**撒谎**。 当模型自信错误时(相同的N个探针,
相同的错误答案 - 零散度),在分歧中是不可见的。 网关是一个
**不确定性信号 → 暂停/升级**,**不是**正确性保证。
**判决优先级**(冲突按构造解决):
1. `exec`/`calc`(硬,物理独立于模型)总是赢 - 网关甚至不会被问到。
2. `lookup`分歧进入可选的`arbiter_fn`;没有一个 → `uncertain`
(如果您的事实基础在查询时是新鲜的,请设置`lookup_hard_block=True`)。
3. `gate`(样本传播)仅在没有验证原子时运行。
4. `veto`是一个正交轴:它判断**动作**,是 fail-closed,并且`guard()`
没有策略会引发而不是默默允许所有操作。
**方法**:`evaluate(q, answer)`验证现有的答案 · `ask(q)`使用`sample_fn`生成
然后验证 · `guard()`用预执行否决装饰工具函数 · `check_action(repr)`
在不运行的情况下评估一个动作。
**`arbiter_fn`合约**:`(question, answer, KorytoVerdict) -> Optional[bool]` -
`True` = 事实基础是正确的(驳斥站立),`False` = 模型是正确的
(过时的基础,答案确认),`None`/异常 = 没有裁决 → `uncertain`。
每个发言阶段都记录在`report.stages`中以便于调试。
**为什么小型/廉价模型**(这是关于不确定性*信号*,而不是否决 - 否决是
模型无关的):代理越来越多地在廉价/本地模型上运行(7-30B via Ollama/vLLM)用于成本
和数据驻留。那里是网关的**不确定性信号**最强(AUC 0.77–0.90,
测量N=4800)而前沿优先的护栏供应商不针对 - 在前沿模型上
*信号*减弱(AUC 0.68–0.71)。动作否决的拒绝名单 + 执行检查不依赖于
模型大小 - 它保护Claude Code(前沿)代理与本地代理完全相同。
*命名说明*:`koryto`(波兰语:河床)是项目的规范术语,用于
确定性验证层 - 概率“河流”(模型输出)由确定性“河床”(执行/计算/查找)持有。
它是一个刻意的品牌术语,而不是翻译事故。
## 交易
六十秒您的时间,交换:
- 一个确定性的门槛,您的代理无法通过运行 `terraform destroy`,`rm -rf`,
`DROP TABLE`或`gh repo delete` - 71个默认策略,用于
不可逆操作类,失败关闭,~0.6%干预率,实测
真实流量(它不会打扰你);
- 一个可以直接粘贴的Claude Code PreToolUse钩子 - 最强模式:
执行环境中的强制执行,在模型的控制流程之外;
- 适用于crewAI / LangGraph / AutoGen的适配器(诚实标记:
进程内约定,较弱钩子);
- 一行卸载,如果它不适用。 最坏的情况,你失去了一分钟。
我们要求你:
- **一份否决故事** - [告诉我们什么被捕获,或者什么溜过去了](https://github.com/BGMLAI/gate.cat/issues/new?template=veto-story.yml)。
报告的漏洞比赞扬更有价值:报告的空白得到修复并在
CHANGELOG中获得积分,绕过套件从这些报告中增长而来……
如果网关曾经阻止了一些愚蠢的东西,请⭐帮助其他人找到这个。
## 定价
**本地网关永久免费** - 包括本地报告。 付费层,
**gate.cat Cloud**,是您否决历史的机器副本 - 单个代理无法删除或重写的副本
(本地日志在破坏半径内)。 发布价格:**Solo €19/mo · Team €149/mo flat(最多10台机器)· Business €499/mo**。
Stripe 结算已启动,自动激活和订阅生命周期处理。
本地网关永久免费。
[立即购买 Solo(€19/mo)](https://buy.stripe.com/7sY6oAaRD5qU79m2Vo67S09) ·
[团队 - €149/mo flat,适用于最多10台机器](https://buy.stripe.com/9B66oA5xj2eIaly2Vo67S0a) ·
[商业版(€499/mo)](https://buy.stripe.com/7sYdR2e3PcTm2T6cvY67S0b) -
或购买一次性€29的政策包:
[金融科技](https://buy.stripe.com/dRm5kw6Bn3iMfFS1Rk67S0c) ·
[PaaS](https://buy.stripe.com/3cI5kw3pbaLeeBO2Vo67S0d) ·
[HTTP-API 宽度](https://buy.stripe.com/aFa8wIgbX06AdxK67A67S0e)。
**运行代理跨团队?** 一个流氓代理的破坏半径是整个
团队的。 团队计划添加一个共享的机器否决历史记录,单个代理无法删除,
fleet 警报和签名策略同步 - 在专用页面上演练:
**[团队计划 → gate.cat/teams.html](https://gate.cat/teams.html)**。
完整的边界和层级详情:[PRICING.md](PRICING.md)。
**教授 AI 编程,或编写开发通讯?** 这里有一个合作伙伴计划 -
30% 经常性,持续到生命周期,基于任何付费计划的启动。
核心功能保持免费,因此您推荐真正有价值的内容,而不是付费墙:
**[合作伙伴计划 → gate.cat/partners.html](https://gate.cat/partners.html)**。
## 验证数字
每个公开的数字都指向 [FACTS.md](FACTS.md) 中的一行(声明 → 源 →
允许的措辞),而语料库的底层测量在
[`scripts/`](scripts/README.md) - 重现它们,如果您的数字
与我们的不符,那就是一个错误报告,我们想要。
~0.6% 声明的 14.7k 命令的一半是我们自己的私有日志(以这种方式标记在
FACTS.md 中);公共语料库的一半您可以自行重新运行。
**召回率** - 我们最关心的声明(有什么危险的东西溜过去了)
在两个轴上进行测量,详见 [RECALL.md](RECALL.md)。 确定性测试不需要
数据集并在几秒钟内运行:
```bash
git clone https://github.com/BGMLAI/gate.cat && cd gate.cat
pip install -e . # 否决引擎(零依赖核心)
python scripts/recall_danger_axis.py # 43个已知危险类别通过完整的网关,0个错误阻止
```
(测试工具位于 `scripts/` - 不随pip轮子一起发布
因此您可以从克隆中验证它,您也可以在那里阅读危险目录
它检查的内容。)
## 缓存 / 缓存增强合成(支持引擎)
上面的验证/否决层运行在语义缓存之上。 单独使用时,
缓存还作为OpenAI/Anthropic SDK的替代包装器,具有三层响应:
原样缓存,合成,向上游 - 缓存语义相似的查询并返回
即时响应(<10ms),或从缓存知识中合成(~300ms,~$0.002)
而不是完整的上游调用。
## 快速入门
### OpenAI(直接替换,零代码更改)
```python
from gatecat import CachedOpenAI
client = CachedOpenAI(api_key="sk-...")
```
###
### 快速开始
### 合作伙伴计划
### 缓存增强合成
### 语义缓存
# 第二次调用相似查询:~5ms(缓存命中)
response2 = client.chat.completions.create(
model="gpt-4o",
messages=[{"role": "user", "content": "法国首都?"}],
)
print(response2.gatecat_hit) # True
### Anthropic
```python
from gatecat import CachedAnthropic
client = CachedAnthropic(api_key="sk-ant-...")
message = client.messages.create(
model="claude-sonnet-4-20250514",
max_tokens=1024,
messages=[{"role": "user", "content": "什么是Python?"}],
)
print(message.gatecat_hit) # True on cache hit
```
### 流式传输
流式传输透明地工作。缓存未命中会缓冲并存储响应;缓存命中会重放为合成流。
```python
stream = client.chat.completions.create(
model="gpt-4o",
messages=[{"role": "user", "content": "解释量子计算"}],
stream=True,
)
for chunk in stream:
print(chunk.choices[0].delta.content or "", end="")
```
### 缓存增强合成(CAS)
当查询与缓存条目相似但不完全匹配时,CAS会使用廉价的大型语言模型从缓存知识中合成新鲜的响应,而不是调用昂贵的上游API。
```python
from gatecat import CachedOpenAI
client = CachedOpenAI(
synthesis_mode="auto", # 启用三层响应
# 默认使用OpenRouter的Gemini Flash Lite(~$0.002/synthesis)
# 或指向本地llama-cpp:synthesis_model="local/phi-4-mini"
)
response = client.chat.completions.create(
model="gpt-4o",
messages=[{"role": "user", "content": "解释光合作用"}],
)
if response.gatecat_hit:
print("逐字缓存命中(<10ms,$0.00)")
elif response.gatecat_synthesized:
print("从缓存合成(~300ms,~$0.002)")
else:
print("上游API调用(~500ms,~$0.03)")
```
```
三层响应:
查询 --> 嵌入 --> HNSW搜索
|
sim >= 0.92 | 逐字命中 --> 返回缓存响应 <10ms $0.00
sim >= 0.80 | 合成 --> Top-K缓存Q&A + LLM ~300ms ~$0.002
sim < 0.80 | 上游未命中 --> 调用API,缓存响应 ~500ms ~$0.03
```
使用5个领域中的100个问题基准验证:**0.892平均质量比率** 与直接API响应相比。
### 代理模式 — 否决任何本地代理,零代码(Ollama / NIM / OpenRouter / vLLM)
Ollama,NIM,OpenRouter,vLLM和LM Studio都使用OpenAI API,因此**一个代理在它们前面保护它们所有** — 您的代理更改一个`base_url`,无需编写代码。当模型要求运行工具时,代理会检查提议的调用是否符合71个默认策略墙(以及您可以加载的任何策略包),并在代理执行它们之前**阻止危险的调用** (`rm -rf`,`terraform destroy`,`DROP TABLE`,磁盘擦除,仓库删除等)。
```bash
pip install "gate-cat[proxy]"
# 将代理指向您的提供商(显示本地Ollama;NIM/OpenRouter/vLLM相同)
export OPENAI_BASE_URL="http://localhost:11434/v1" # 您的真实提供商
export GATECAT_ALLOW_INSECURE_UPSTREAM=1 # 仅适用于本地http提供商
gatecat-proxy # 监听:8080
```
然后,您的代理指向代理而不是提供商 — 这就是全部的改变:
```python
client = OpenAI(base_url="http://localhost:8080/v1") # 之前是11434;现在受到保护
```
危险的工具调用会作为拒绝而不是执行而返回。模式:`GATECAT_PROXY_TOOL_VETO=block`(默认)/ `flag`(仅注释)/ `off`。
注意事项:此功能门控模型通过API进行的工具调用;直接shell-out的代理仍需要harness钩子(`gatecat-hook`)。
---
以独立的代理服务器运行gate.cat。无需SDK集成 — 只需更改`base_url`:
```bash
# Docker(推荐)
docker run -e OPENAI_API_KEY=sk-... -p 8080:8080 gatecat/proxy
# 或pip
pip install "gate-cat[proxy]"
gatecat-proxy # 在:8080上启动
```
然后将您的现有代码指向代理:
```python
from openai import OpenAI
client = OpenAI(base_url="http://localhost:8080/v1") # 就是这样
response = client.chat.completions.create(
model="gpt-4o",
messages=[{"role": "user", "content": "什么是Python?"}],
)
# 缓存头:X-Gatecat-Hit,X-Gatecat-Synthesized
```
与任何OpenAI兼容的客户端(curl,LangChain,LiteLLM等)一起使用。 通过环境变量配置:
| 变量 | 默认值 | 描述 |
|----------|---------|-------------|
| `OPENAI_API_KEY` | — | 上游提供商的API密钥 |
| `GATECAT_SIMILARITY_THRESHOLD` | `0.92` | 缓存命中阈值 |
| `GATECAT_SYNTHESIS_MODE` | `off` | `off` / `auto` / `always` |
| `GATECAT_TTL` | `86400` | 缓存TTL(秒) |
| `GATECAT_PORT` | `8080` | 服务器端口 |
### 异步
```python
from gatecat import AsyncCachedOpenAI, AsyncCachedAnthropic
async_client = AsyncCachedOpenAI()
response = await async_client.chat.completions.create(
model="gpt-4o",
messages=[{"role": "user", "content": "你好"}],
)
```
### 独立缓存
直接为任何基于嵌入的缓存使用`SemanticCache`:
```python
from gatecat import SemanticCache
cache = SemanticCache(
similarity_threshold=0.92,
cache_ttl=86400, # 24小时
)
cache.populate("什么是Python?", "Python是一种编程语言...")
result = cache.lookup("告诉我关于Python") # 缓存命中
```
### 负缓存(黑名单)
在查询到达API之前阻止已知的坏查询模式:
```python
# 阻止查询模式
client.cache.negative.add(
"无载燕子飞行速度是多少?",
reason="幻觉",
)
# 相似查询现在被阻止
client.cache.negative.check("燕子飞行速度") # 返回匹配信息
# 管理黑名单
client.cache.negative.list(limit=50)
client.cache.negative.remove(entry_id=42)
client.cache.negative.report_false_positive(entry_id=42)
```
## 配置
```python
client = CachedOpenAI(
# 缓存设置
cache_dir="~/.gatecat", # 存储缓存数据的位置
similarity_threshold=0.92, # 缓存命中余弦相似度(0-1)
negative_threshold=0.85, # 负缓存阈值
cache_ttl=86400, # TTL(秒)
cache_max_entries=100_000, # 最大条目数,超过后进行LRU淘汰
cache_enabled=True, # 设置为False以禁用
on_negative_hit="raise", # "raise" | "skip" | 可调用
# 合成设置(CAS)
synthesis_mode="off", # "off" | "auto" | "always"
synthesis_model="google/gemini-2.0-flash-lite-001", # 任何OpenAI兼容模型
synthesis_model_base_url=None, # 从OPENROUTER_API_KEY自动检测
synthesis_model_api_key=None, # 从环境变量自动检测
synthesis_threshold=0.80, # 合成候选的最小相似度
synthesis_top_k=5, # 合成使用的缓存Q&A对数量
# OpenAI设置(直通)
api_key="sk-...",
)
```
## 工作原理
```
查询 --> 嵌入(MiniLM-L6,384-dim) --> 搜索HNSW索引
|-- 逐字命中 (sim >= 0.92) --> 返回缓存响应(<10ms)
|-- 合成 (sim >= 0.80) --> Top-K缓存Q&A + 廉价LLM(~300ms)
'-- 未命中 (sim < 0.80) --> 调用上游API,缓存响应(~500ms)
```
- **嵌入器**:ONNX MiniLM-L6-v2(90MB,在本地运行,无API调用)
- **索引**:hnswlib HNSW用于快速近邻搜索
- **存储**:SQLite,带WAL模式,用于并发访问
- **回退**:如果hnswlib不可用,则使用numpy强力搜索
## 命令行界面
```bash
gatecat-cli stats # 显示缓存统计信息
gatecat-cli entries # 列出缓存条目
gatecat-cli evict # 删除过期条目
gatecat-cli clear # 清除所有条目
gatecat-cli lookup "查询" # 测试缓存查找
```
## 自定义嵌入器
为任何模态注册您自己的嵌入器:
```python
from gatecat.embedders import BaseEmbedder, register_embedder
import numpy as np
class MyEmbedder(BaseEmbedder):
dim = 256
modality = "custom"
def encode(self, input_data) -> np.ndarray:
# 您在此处编写嵌入逻辑
...
register_embedder("my-embedder", MyEmbedder)
cache = SemanticCache(embedder="my-embedder")
```
内置嵌入器:`minilm`(文本),`clip`(图像,即将推出),`clap`(语音,即将推出)。
## 比较
| 功能 | gate.cat | GPTCache | LiteLLM | Redis LangCache |
|---------|-----------|----------|---------|-----------------|
| 语义相似性 | 是 | 是 | 仅精确匹配 | 是 |
| 缓存增强合成 | 是 | 否 | 否 | 否 |
| OpenAI直连 | 是 | 部分 | 是 | 否 |
| Anthropic直连 | 是 | 否 | 是 | 否 |
| 流式支持 | 是 | 否 | 否 | 否 |
| 负缓存 | 是 | 否 | 否 | 否 |
| 多模态(计划) | 是 | 否 | 否 | 否 |
| 异步 | 是 | 否 | 是 | 否 |
| 零配置 | 是 | 否 | 否 | 否 |
| 代理模式(Docker) | 是 | 否 | 是 | 否 |
| 本地(无服务器) | 是 | 是 | 否 | 否 |
| 许可证 | Apache 2.0 | MIT | MIT | Redis |
## 许可证
Apache 2.0 — 请参阅 [LICENSE](LICENSE)。
由 [BGML.ai](https://bgml.ai) / [Fundacja BLOOM](https://bloom.foundation)构建。
策略包 → [gate.cat/#packs](https://gate.cat/#packs)
MCP 配置
以下是此 MCP Server 的配置信息,可直接复制到 Cursor 或其他 MCP 客户端中使用。
mcp.json
连接信息
猜你喜欢
暂无推荐服务器