
内容
# 柯特斯协议
🧠 **一份记忆。每个代理。** — 用户拥有,跨代理的基于模型上下文协议的AI记忆。
[](https://pypi.org/project/cortex-protocol/)
[](https://pypi.org/project/cortex-protocol/)
[](https://pypi.org/project/cortex-protocol/)
[](https://github.com/fernsdavid25/cortex-protocol/blob/main/LICENSE)
[](https://github.com/fernsdavid25/cortex-protocol/actions/workflows/ci.yml)
[](https://codecov.io/gh/fernsdavid25/cortex-protocol)
**与 Claude Code · Cursor · Claude Desktop · VS Code 兼容**
您拥有 **一份** 可移植的记忆,任何 AI 代理都可以通过 MCP 在您的同意下与其连接。
您可以将其作为本地_stdio_服务器进行自我托管 — 一个 SQLite 文件,您自己的 Gemini 密钥(BYOK),**没有任何数据上报** — 而 `recall` **不进行** 服务器端 LLM 生成,因此唯一的运行时成本是您自己的嵌入令牌。
> **📊 0.932 LongMemEval_S · 0.813 LoCoMo** — 唯一一个发布每问题的美元成本的记忆系统,并且是唯一一个在 LongMemEval_S 上达到 0.9+ 且具有成本效益的读者:一个 **Gemini Flash 读者**,在 LongMemEval_S 上 **约 0.0396 美元/问题**,在 LoCoMo 上 **约 0.0034 美元/问题**。† 原始排名:**LongMemEval_S 上排名第 2**(落后于 Mastra 0.949),**LoCoMo 上排名第 3**。在 [结果](#结果) 中查看裁判披露。
<sub>† 每个问题的成本根据谷歌确认的列表价格(付费层级)中测量的令牌数量计算。</sub>
## 快速入门 — 自托管(代理中的本地记忆)
本地服务器(`cortex-mcp`)是一个 **stdio MCP 服务器**:您自己的 Gemini 密钥(BYOK),本地 SQLite 文件中的记忆(`~/.cortex/memory.db`),**没有任何数据上报**。
1. **获取 Gemini 密钥**(免费):<https://aistudio.google.com/apikey>
2. **将 Cortex 添加到您的 MCP 客户端。** 每个客户端都使用相同的 `mcpServers` 形状 — 只有文件不同:
```json
{
"mcpServers": {
"cortex": {
"command": "uvx",
"args": ["--from", "cortex-protocol", "cortex-mcp"],
"env": { "GEMINI_API_KEY": "your-key-here" }
}
}
}
```
| 客户端 | 配置文件 |
|---|---|
| **Claude Code** | `~/.claude.json`(全局),或项目中的 `.mcp.json` |
| **Cursor** | `~/.cursor/mcp.json`(全局),或项目中的 `.cursor/mcp.json` |
| **Claude Desktop** | `claude_desktop_config.json`(设置 → 开发者 → 编辑配置) |
| **VS Code** | `.vscode/mcp.json` |
重启客户端。这会暴露六种工具(最后两种是基于选择加入的记忆层 — 请参见下面的**配置(环境变量)**):
| 工具 | 功能 |
|---|---|
| `memorize(content, kind?, tags?)` | 保存持久记忆(可选分类为六种类型之一)。 |
| `recall(query, limit?)` | 检索最相关的记忆(混合密集 + BM25,RRF;无 LLM 生成)。 |
| `list_memories(limit?)` | 列出最近的记忆。 |
| `forget(memory_id)` | 删除记忆(如果明确,短 ID 前缀有效)。 |
| `recall_about(entity, limit?)` | 针对一个实体的详尽档案 — 一个人、地点、项目、组织、事物或您自己 — 每个关系和每个附加的记忆。纯粹的按键读取,无 LLM/嵌入调用。**需要 `CORTEX_GRAPH=1`。** |
| `recall_timeline(since?, until?, limit?)` | 按时间顺序排列的事件时间线 — 按提取的 `event_time`(用于“发生了什么时间”的问题)排序的记忆,可选地以 ISO 日期为界限。纯粹的按键读取,无 LLM/嵌入调用。**需要 `CORTEX_EPISODIC=1`。** |
**从检出**(运行您自己的工作副本而不是发布的包):`python -m cortex.mcp.server`,或在客户端配置中使用 `"command": "uv", "args": ["run", "--with", "fastmcp", "python", "-m", "cortex.mcp.server"]`。注意上面的 `--from cortex-protocol` — 裸露的 `uvx cortex-mcp` 解析为一个无关的包。
**配置(环境变量):** `GEMINI_API_KEY` / `GOOGLE_API_KEY`(必需);可选 `CORTEX_DB_PATH`,`CORTEX_USER_ID`,`CORTEX_EMBED_MODEL`,`CORTEX_EMBED_DIM`,`CORTEX_TOP_K`(默认回忆深度 5)。
**选择加入的记忆层(默认关闭)。** `CORTEX_GRAPH=1` 构建实体图并启用 `recall_about`;`CORTEX_EPISODIC=1` 构建事件时间/参与者/位置并启用 `recall_timeline`;`CORTEX_EXTRACT_MODEL`(默认 `gemini-2.5-flash-lite`)是执行提取的模型。启用任一功能都会在 **每个 `memorize` 上添加一个廉价的 flash-lite 调用(仅写入时间,在您自己的密钥上 — 当两者都开启时,它们共享一个提取调用)**。 **`recall` 保持字节不变**,因此发布的回忆成本不变。参见 [`examples/`](https://github.com/fernsdavid25/cortex-protocol/tree/main/examples) 和 [`.env.example`](https://github.com/fernsdavid25/cortex-protocol/blob/main/.env.example)。
**Claude Desktop 一键式:** 构建 `.mcpb` 包并将其拖放到 Desktop — 它会提示您输入 Gemini 密钥并运行相同的六种工具。参见 [`packaging/mcpb/`](https://github.com/fernsdavid25/cortex-protocol/tree/main/packaging/mcpb)。
## 为什么选择 Cortex
- **用户拥有,而非公司拥有。** *您* 决定哪些代理可以看到您的记忆 — 而不是现有的业务拥有它。 一份记忆,每个代理。
- **成本已公布。** ~0.0396 美元/问题在 LongMemEval_S 上,~0.0034 美元在 LoCoMo† — 按谷歌确认的列表价格计算的令牌数量。 没有其他记忆系统发布每问题的美元成本,因此无法进行比较。 它针对 **每美元的准确性**,而不是任何成本下的原始准确性。
- **任何地方运行,无需运营成本。** 自托管是一个单一的 SQLite 文件 — 无需 Docker,无需数据库服务器。 一个配置片段将其连接到任何 MCP 客户端。
## 结果
**📊 0.932 LongMemEval_S · 0.813 LoCoMo.** 两个公共长期记忆基准,声明的原始排名:**LongMemEval_S 上排名第 2**(落后于 Mastra 0.949),**LoCoMo 上排名第 3**。 区别在于成本方面 — Cortex 是唯一一个发布每问题美元成本的记忆系统,并且是唯一一个在 LongMemEval_S 上达到 0.9+ 且具有成本效益的读者。 没有竞争对手的每问题美元成本被衡量过,我们或他们都没有,因此无法进行成本比较。
| 基准 | Cortex | 原始排名 | 读者(成本†) | Recall@k(会话级‡) |
|---|---|---|---|---|
| **LongMemEval_S**(500 题) | **0.932** | 原始排名第 2 | `gemini-3.5-flash`,`top_k=50`,偏好模式,答案优先 · **约 0.0396 美元/问题** | 0.998 |
| **LoCoMo**(1986 题) | **0.813** | 原始排名第 3 | `gemini-2.5-flash`,`top_k=100`,答案优先 · **约 0.0034 美元/问题** | 0.998 |
<sub>† 每问题成本根据谷歌确认的列表价格(付费层级)中测量的令牌数量计算。</sub>
> **‡ 按字面意思理解这个召回数字。** 它是 **会话级**:当检索的集合包含黄金证据时,它会记为命中。 在 LongMemEval 上,这是数据集自己的黄金粒度,因此 0.998 是根据基准定义的精确度。 在 LoCoMo 上,数据集提供 **按回合级别的证据**(`"D1:3"` = 会话 1,回合 3),因此会话级召回率回答了更简单的问题。 测量的回合级完整证据覆盖率在 LoCoMo 上为 **k=100 时为 0.915,k=8 时为 0.639** — 读取 0.998 为“我们浮现了正确的对话”,而不是“我们浮现了正确的记忆”。
### 读者前沿 — 用美元购买准确性,而不是不同的记忆系统
相同的检索,相同的 500 个问题,相同的提示 — 只有读者模型不同。 这是内存层暴露的权衡,定价:
| 读者(LongMemEval_S,n=500) | 准确性 | 每问题美元 | **正确**答案的成本 |
|---|:--:|:--:|:--:|
| `gemini-2.5-flash` | 0.848 | **0.0079 美元** | 0.0093 美元 |
| `gemini-3.5-flash` | **0.932** | 0.0396 美元 | 0.0425 美元 |
**+8.4 准确性积分,读者成本约为 5 倍,固定记忆系统。** 检索在两个组之间是字节相同的 — 相同的索引,相同的 top-k,相同的融合排名 — 因此差异是读者能力,而不是检索。 使用 `CORTEX_READER_MODEL` 选择曲线上的点;其他内容不变。
### Cortex 比较(LongMemEval_S)
| 系统 | LongMemEval_S | 读者 | ~$/q | 裁判 |
|---|---|---|---|---|
| **Cortex**(此仓库) | **0.932** | `gemini-3.5-flash`(成本效益层级) | **~0.0396** | gemini-flash |
| Mastra | 0.949 | `gpt-5-mini`(高级) | — | GPT-4o |
| Zep / Graphiti | 0.712 | `gpt-4o`(高级) | — | GPT-4o |
| Mem0 | 未发布¹ | — (图) | — | — |
<sub>数字来自已验证的[排行榜研究](https://github.com/fernsdavid25/cortex-protocol/blob/main/bench/results/leaderboard_research.md)。 **不是完全相同的比较:** 竞争者的分数是在他们自己的裁判下自我报告的;Cortex 由 `gemini-3.5-flash` 裁判评分(可能比规范的 `gpt-4o-2024-08-06` 更宽容),而 ~$/q 仅在 Cortex 衡量时发布 — 没有竞争对手的 $/q 被衡量。 ¹Mem0 没有可验证的 LongMemEval_S 数字通过验证 — 它报告 LoCoMo(0.61–0.66)代替。</sub>
> **裁判披露(负载)。** 所有的 Cortex 数字都由 **LLM 裁判 = `gemini-3.5-flash`** 评分。 规范的 LongMemEval 裁判是 `gpt-4o-2024-08-06`;Gemini 裁判可能 **更宽容**,因此使用 OpenAI 密钥进行 GPT-4o 重新评级(待定)可能会降低这些数字。 标题运行还使用 **与读者和裁判相同的模型家族**,因此不能排除自偏见并计划进行跨家族重新评级。 作为一个跨模型健全性检查,一个独立的 Claude 小组重新评级了所有 282 个 LoCoMo 多跳案例,并与套件密切跟踪(小组 0.528 与套件 0.589)。发布的 **$/问题** 根据谷歌确认的列表价格从令牌数量中衡量,不依赖于裁判。
**LongMemEval_S 0.932** — 按问题类型:单会话用户 0.957,单会话助手 0.982,单会话偏好 0.900,知识更新 0.949,时间推理 0.925,多会话 0.902,放弃 0.867(平均约 25.7k 输入令牌/问题)。 在我们的裁判下,0.932 位于 **ByteRover(0.928,声称)和 Hindsight(0.914)** 之间,仅次于高级读者领袖 **Mastra(0.949,gpt-5-mini)** — 同时超过 Emergence(0.860),Supermemory(0.852)和 Zep(0.712),所有这些都使用更昂贵的读者。 *(竞争者行使用他们自己的裁判 — 排行榜不完全相同;规范裁判是 GPT-4o。)*
#### 按问题类型 — Cortex 与领域
一个整体数字隐藏了记忆系统赢或输的地方。 按 LongMemEval_S 问题类型划分,Cortex — **领域中唯一具有成本效益的读者系统** — 保持在高级读者系统的顶层,并直接领先于单会话助手和多会话召回:
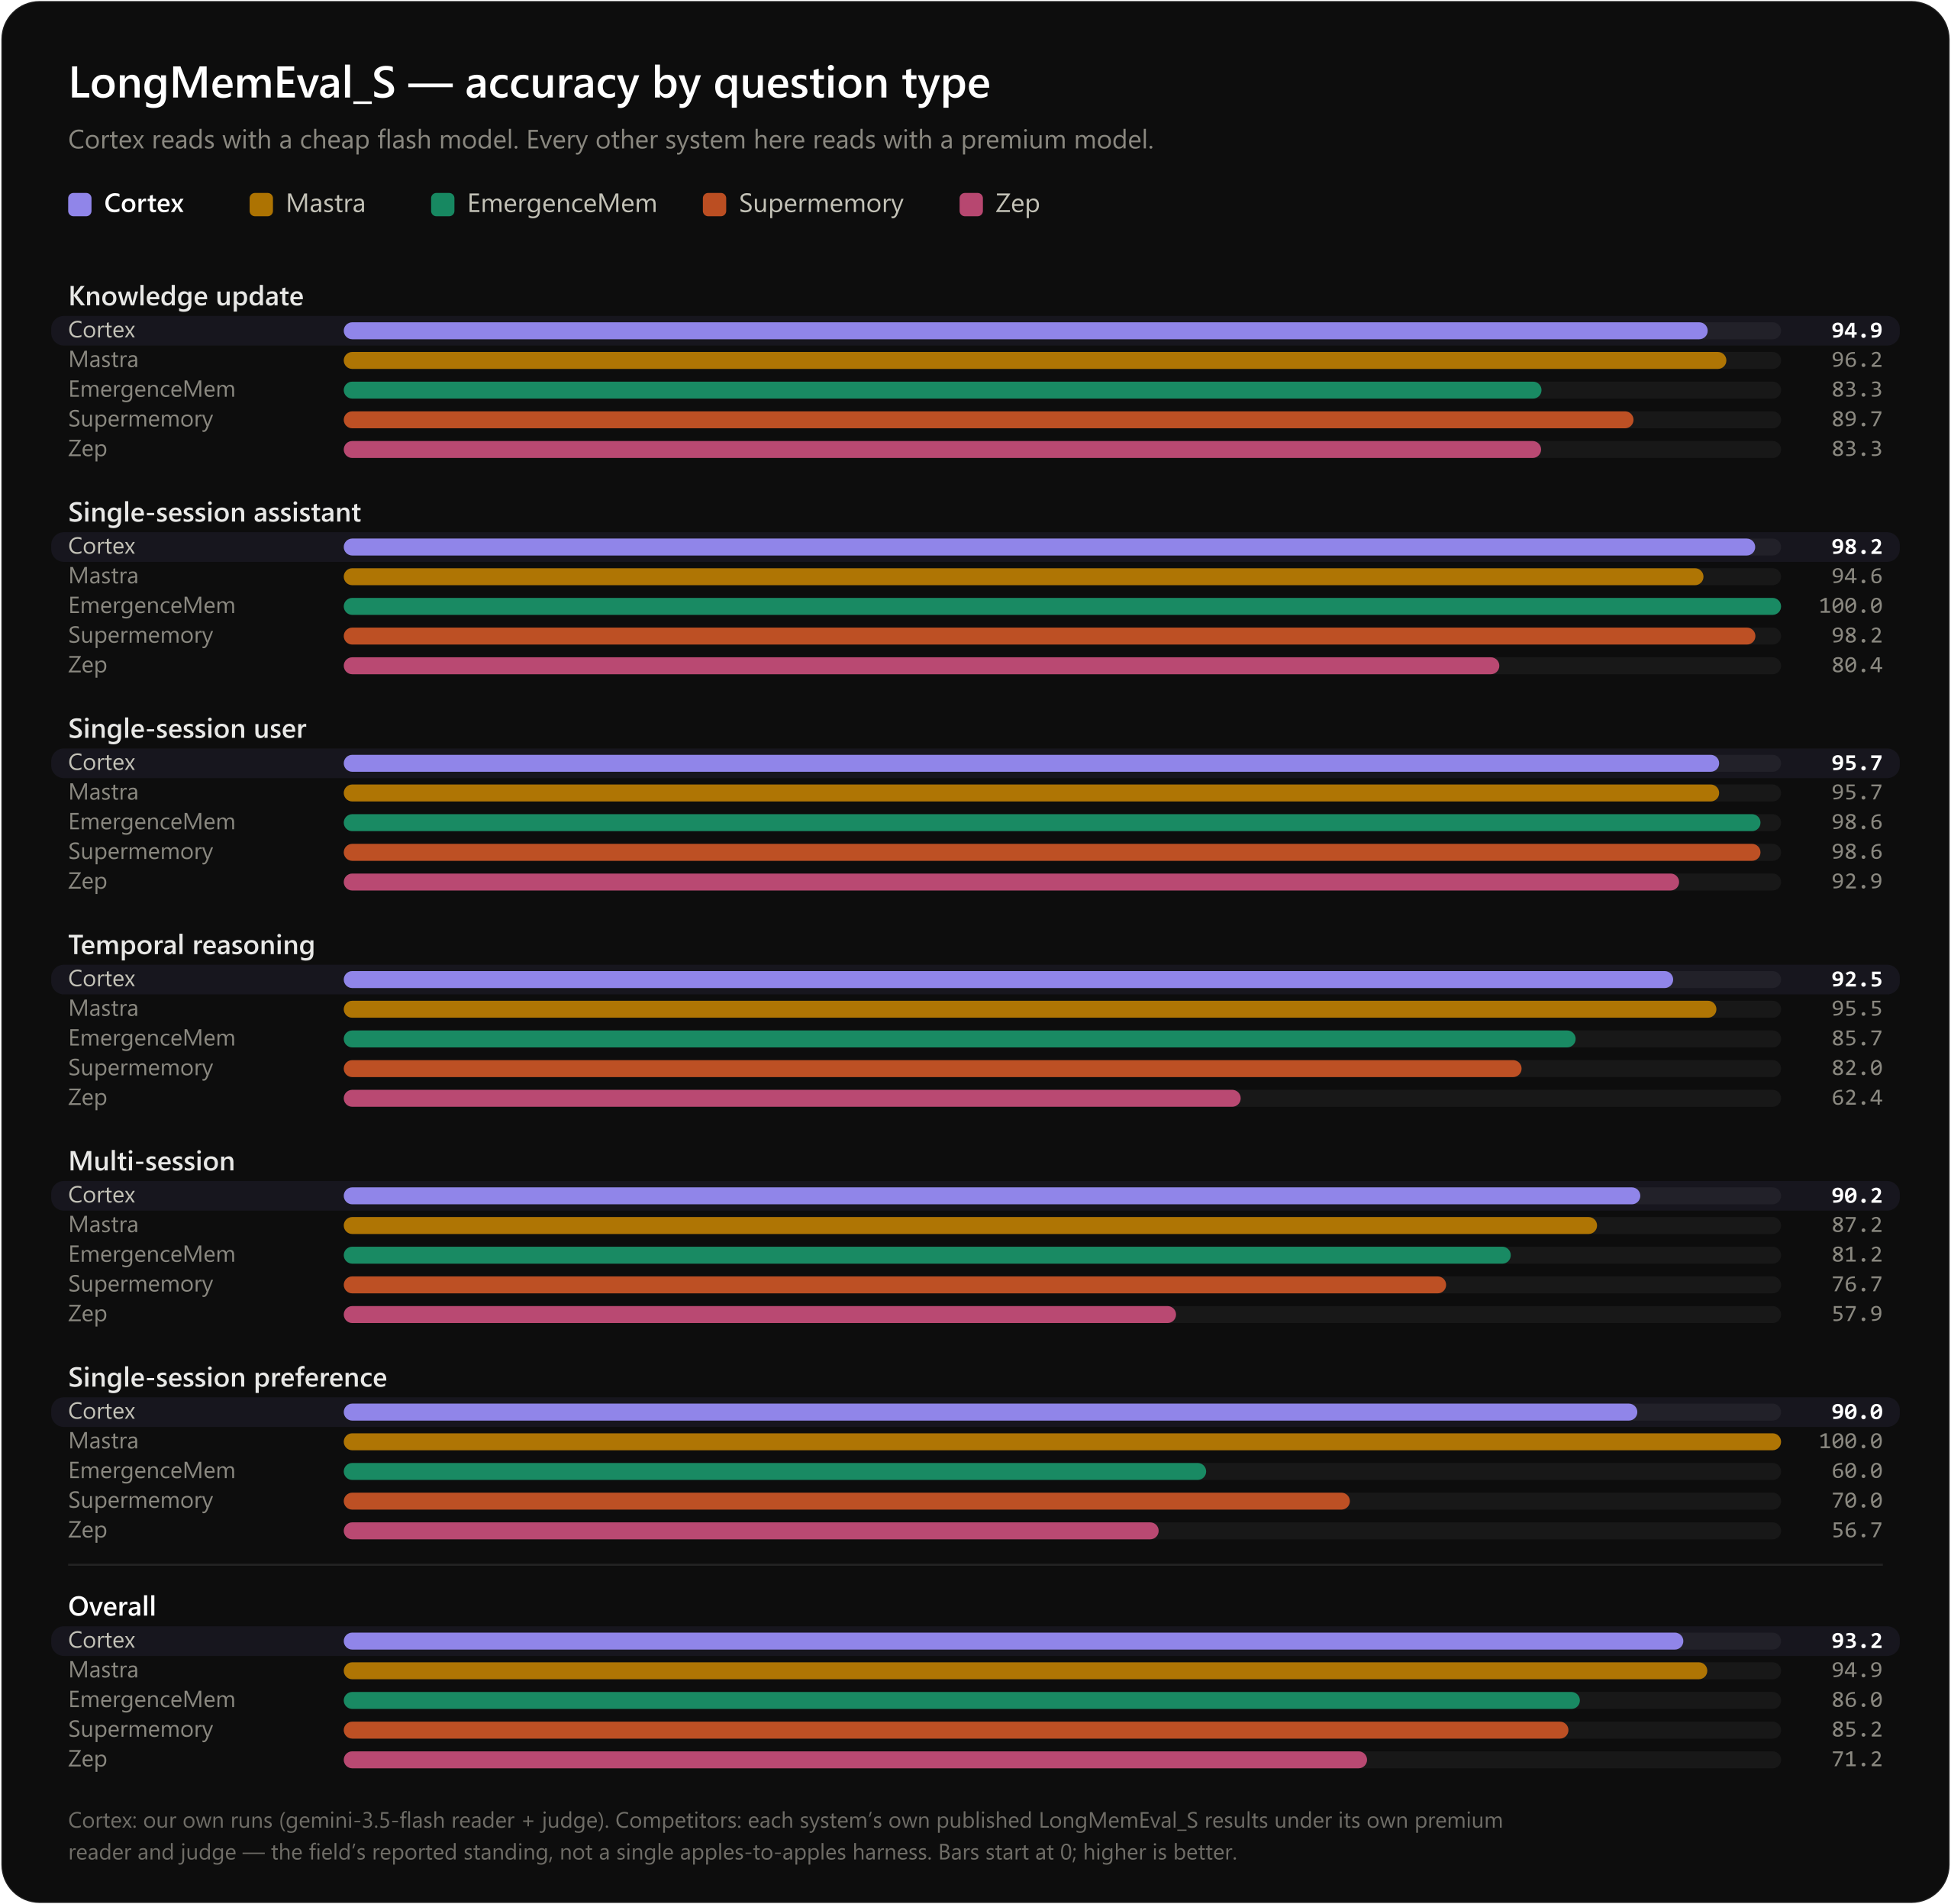
| 问题类型 | **Cortex** `flash` | Mastra `premium` | EmergenceMem `premium` | Supermemory `premium` | Zep `premium` |
|---|:--:|:--:|:--:|:--:|:--:|
| 知识更新 | **94.9** | 96.2 | 83.3 | 89.7 | 83.3 |
| 单会话助手 | **98.2** | 94.6 | 100.0 | 98.2 | 80.4 |
| 单会话用户 | **95.7** | 95.7 | 98.6 | 98.6 | 92.9 |
| 时间推理 | **92.5** | 95.5 | 85.7 | 82.0 | 62.4 |
| 多会话 | **90.2** | 87.2 | 81.2 | 76.7 | 57.9 |
| 单会话偏好 | **90.0** | 100.0 | 60.0 | 70.0 | 56.7 |
| **整体** | **93.2** | 94.9 | 86.0 | 85.2 | 71.2 |
<sub>Cortex 的行是我们自己的运行(`gemini-3.5-flash` 读者 + 裁判)。竞争者的行是每个系统在其 **自己的高级读者和裁判** 下发布的 LongMemEval_S 结果 — 领域的报告立场,**不是** 单个苹果对苹果的套件(抛去 Supermemory 的“8/12 变体集合”栏目作为讽刺;使用真正的 *初始* 栏目)。Cortex 的放弃类别(0.867)被省略 — 竞争者不报告它。越高越好。</sub>
**LoCoMo 0.813** — 按类别:单跳 0.864,多跳 0.695,时间 0.857,开放领域 0.458,对抗性/放弃 0.836。这个 **击败图内存系统** (Mem0 0.61–0.66,Zep 0.585–0.62)和 **与强检索基线 EMem 相当** (0.78–0.84),落后于只有 Cognis(~0.925,Claude-Opus 读者 + 重新排序器)。将检索深度加倍(k=50→100)就是恢复多跳(+10.6pt) — LoCoMo 前沿是检索深度,而不是读者能力。
### 复制
```bash
# LongMemEval_S — 0.932 标题(完整 500 题):
python -m cortex_bench.run --system cortex-v0 --variant s --limit 500 \
--reader-model gemini-3.5-flash --top-k 50 --preference-mode --answer-first \
--max-output-tokens 8192 --judge gemini --judge-votes 3
# LongMemEval_S — 经济型读者前沿(0.848),相同检索,更便宜的读者:
python -m cortex_bench.run --system cortex-v0 --variant s --limit 500 \
--reader-model gemini-2.5-flash --top-k 50 --preference-mode --answer-first \
--max-output-tokens 8192 --judge gemini --judge-votes 3
# LoCoMo — 0.813(先将 locomo10.json 放入 bench/data/ 目录):
python -m cortex_bench.run --system cortex-v0 --locomo --reader-model gemini-2.5-flash \
--top-k 100 --answer-first --max-output-tokens 8192 --judge gemini
```
完整的 方法论 + 按类型表格:
[`bench/results/PHASE3_authoritative.md`](https://github.com/fernsdavid25/cortex-protocol/blob/main/bench/results/PHASE3_authoritative.md)
(LongMemEval)和
[`bench/results/LOCOMO_results.md`](https://github.com/fernsdavid25/cortex-protocol/blob/main/bench/results/LOCOMO_results.md)
(LoCoMo);已验证的竞争者排行榜:
[`bench/results/leaderboard_research.md`](https://github.com/fernsdavid25/cortex-protocol/blob/main/bench/results/leaderboard_research.md).
## 功能
| 能力 | 功能 | 状态 |
|---|---|---|
| **混合检索** | 密集(Gemini 嵌入)+ Okapi BM25,融合后使用相互排名融合(`k=60`,无权重);每个检索器都被要求提供一个 `4 × top_k` 候选池,以便融合可以促进双方同意的内容。深度 top-k 驱动会话级召回率 ≈ 0.998。 | **开启**(所有路径) |
| **链式阅读器** | 阅读器在检索的记忆上采取结构化笔记,然后回答,并 **校准放弃** — 当没有记忆支持答案时,它会拒绝而不是编造。 | **开启**(基准测试路径) |
| **情景记忆 + `recall_timeline`** | 一个廉价的 `gemini-2.5-flash-lite` 调用/ `memorize` 构建事件时间/参与者/位置,并支持 `recall_timeline` 工具。**仅写入时间成本 — 回忆是字节不变的**,因此发布的回忆成本不变。 | 可选(`CORTEX_EPISODIC=1`) |
| **实体图 + `recall_about`** | 在 `memorize` 时,实体和关系被折叠到 **相同的** 廉价提取调用中,该调用执行情景提取。构建一个以合成的 `self` 实体为根的自我知识图 — 类型节点(人/地点/组织/项目/事物)通过标记的有向关系连接,每个记忆都附加到它所关乎的实体 — 并支持 `recall_about` 工具。**仅写入时间成本 — 回忆保持字节不变。** | 可选(`CORTEX_GRAPH=1`) |
| **抗饱和** | 写入时 **去重** (仅嵌入,无 LLM)限制存储增长;**矛盾软更新** (一个廉价的仲裁调用)写入一个 `supersessions` 行,以便回忆仅返回最新值。已实施和单元测试;**尚未在大规模上衡量** — 没有已发布的饱和基准测试。 | 引擎级,可选 |
参见 [`docs/decades-scale.md`](https://github.com/fernsdavid25/cortex-protocol/blob/main/docs/decades-scale.md)
了解数十年来可扩展的检索分析(自托管 SQLite 回忆为 O(n):约 95 毫秒 @ 1k 记忆 → 约 7.7 秒 p50 @ 50k)。
## 架构
两条路径,第二条路径永远不会调用LLM。
```mermaid
flowchart TB
subgraph W["① 保存 — 您告诉代理一些值得保存的内容"]
direction LR
W1["memorize()"] --> W2["将其转换为<br/>可搜索的格式"] --> W3["记录下来"]
end
DB[("您的记忆<br/><i>一个文件,它属于您</i>")]
subgraph R["② 回忆 — 不同的聊天,几天后 — 这里不运行AI模型"]
direction LR
R1["recall()"] --> R2["以两种方式搜索 —<br/>按含义和<br/>按确切词"] --> R3["返回<br/>重要的记忆"]
end
A["您的AI读取它们<br/>并回答您"]
W3 --> DB --> R2
R3 --> A
classDef step fill:#1b2a3d,stroke:#4b6a8a,color:#e6eefc
class W1,W2,W3,R1,R2,R3 step
style W fill:#0d1b2a,stroke:#3b82f6,color:#93c5fd
style R fill:#0c1f17,stroke:#22c55e,color:#86efac
style DB fill:#241f38,stroke:#a78bfa,color:#ddd6fe
style A fill:#141414,stroke:#9ca3af,color:#f3f4f6
```
**不变式:** 每个增强层都在**写入**时运行。启用它们会改变存储的内容,但不会改变`recall`的行为 — 因此发布的每次调用成本都保持不变,无论您启用多少层。`recall`是一个嵌入调用加上本地搜索,返回原始记忆。**读取路径上永远不会运行LLM。**
### `hybrid_retrieve`内部
稠密检索和词法检索在不同方面失败:嵌入式检索会错过罕见的确切标记(名称、ID、日期),BM25会错过改述。互惠排名融合结合了它们**,无需标准化分数** — 每个列表都按**排名**投票,因此一个记忆被两个检索器都喜欢的记忆胜过一个检索器喜欢的记忆([Cormack 等,2009](https://dl.acm.org/doi/10.1145/1571941.1572114))。
```mermaid
flowchart LR
classDef q fill:#111,stroke:#666,color:#eee
classDef ret fill:#1a3d2e,stroke:#22c55e,color:#e6f7ee
classDef fuse fill:#2d2a3e,stroke:#a78bfa,color:#f0ecff
classDef out fill:#1e3a5f,stroke:#3b82f6,color:#e8f0fe
Q["查询"]:::q
E["嵌入一次"]:::q
D["<b>稠密</b><br/>向量余弦<br/><i>捕捉改述</i>"]:::ret
L["<b>词法</b><br/>Okapi BM25<br/><i>捕捉确切标记</i>"]:::ret
F{"<b>RRF</b><br/>k=60<br/>排名投票融合"}:::fuse
O["前k个记忆"]:::out
Q --> E --> D
Q --> L
D -->|"4 × top_k池"| F
L -->|"4 × top_k池"| F
F --> O
```
## 教你的代理有效使用Cortex
连接服务器为你的代理提供了*工具*;**Cortex代理技能**赋予了它*技巧* — 哪个工具回答哪种问题,如何措辞记忆以使实体图谱和时间线实际构建,以及何时回忆而不是重新询问你。一个文件,适用于任何客户端(Claude Code技能、Cursor规则或粘贴指令):
```bash
mkdir -p ~/.claude/skills/using-cortex-memory
curl -fsSL https://raw.githubusercontent.com/fernsdavid25/cortex-protocol/main/skills/using-cortex-memory/SKILL.md \
-o ~/.claude/skills/using-cortex-memory/SKILL.md
```
标准文件:[`skills/using-cortex-memory/SKILL.md`](https://github.com/fernsdavid25/cortex-protocol/blob/main/skills/using-cortex-memory/SKILL.md)
· 渲染:[docs → 代理技能](https://fernsdavid25.github.io/cortex-protocol/agent-skill/).
## 安全与隐私
- **BYOK,无需联网。** 你的Gemini密钥从环境变量读取,仅用于调用Google的API。本地服务器无后端,不会发送任何数据。
- **你的记忆文本由Google嵌入。** 每次`memorize`/`recall`都会将内容/查询发送到Google的嵌入式API**,使用你自己的密钥** — 选择一个数据处理条款让你满意的密钥/项目。
- **本地存储是一个纯文本文件。** 记忆以纯文本存储在`~/.cortex/memory.db`(`CORTEX_DB_PATH`)中。不要存储秘密;像保护本地数据一样保护该文件,并仅从受信任的配置文件(而不是不受信任的代理输入)设置`CORTEX_DB_PATH`。
## 开发
```bash
uv run pytest # 离线,确定性测试套件(FakeProvider — 无实时LLM调用)
uvx ruff check server # lint
```
参见 [`CHANGELOG.md`](https://github.com/fernsdavid25/cortex-protocol/blob/main/CHANGELOG.md) 了解发布说明,以及 [`bench/README.md`](https://github.com/fernsdavid25/cortex-protocol/blob/main/bench/README.md) 了解基准测试框架。
## 许可证
[Apache-2.0](https://github.com/fernsdavid25/cortex-protocol/blob/main/LICENSE)
MCP 配置
以下是此 MCP Server 的配置信息,可直接复制到 Cursor 或其他 MCP 客户端中使用。
mcp.json
连接信息
猜你喜欢
暂无推荐服务器